

本文整理自 WhynotTV Podcast 第5期,嘉宾为佐治亚理工助理教授徐丹飞(Danfei Xu)。原采访时长约 2 小时 17 分钟,以下文字经整理,已去除重复内容,保留核心叙述与观点,部分精彩原话以引号保留。
采访者:何泰然(tairanhe.com)
一、从山西太原到美国,一个不走寻常路的少年
徐丹飞出生于山西太原,六年级时随家人搬到上海,在那里读完初中和高中。他描述自己是一个"非常 interest driven 的人"——感兴趣的事情他会全力以赴,不感兴趣的则完全不在状态。
学校对他来说基本上是个社交场所,而不是获得成就感的地方。他从初中开始折腾单片机小车,自己在淘宝买零件、找教程,那个"让东西动起来"的念头从没消散过。
高一的时候去了一趟美国,然后下定了决心——要去美国读本科。
"就是那次以后,我大概就下定决心要干这件事情,there's no way to turn back from there。"
于是他开始脱产,一个人准备美本申请。父母不懂这套,他就在 QQ 群和一个叫 COUS 的留学论坛上收集信息,所有事情自己搞定。
"我爸爸只负责:我说我要考试,他说好,他们只需要给我出钱。"
整个年级去美国的就两三个人,但这对他来说不是压力,反而是一件"更 exciting 的事"。最终他申请到了一所文理学院 Dickinson College,并在那里开始了真正的探索。
二、Cold call Boston Dynamics、开车敲教授的门
到了大一,他对做 robotics research 的渴望已经压不住了——于是开始给公司打电话。
"我打了大概 20 多个电话,包括 Boston Dynamics,包括一些很奇怪的公司。"
最终,一家叫 SynTouch 的触觉传感器公司接了电话。对方是 Jeremy Fishel,他们的传感器产品 BioTac 是当时比较前沿的仿生触觉传感器,能感知压力、热传导速度和高频振动。Fishel 觉得这个学生有点意思,就说:那你来吧,我们不给你钱。
他就飞到了洛杉矶。
第二件离谱的事:在 Carnegie Mellon 举办的 RSS 暑期项目第一届,他听说有一个做自动驾驶的教授可能会感兴趣,直接发了封邮件,教授回说"有可能合适",于是他开车四小时从学校杀到了 CMU,直接敲门:"要不要聊聊?"教授说:你来了,那聊吧。
那个暑假他们开着一辆挂了 6 台摄像头的改装车,每周有两天在匹兹堡街头收集地图数据。
"我觉得哇这个太帅了,天天跟硬件待在一起。"
三、去 Stanford,跑进一片"机器人荒漠"
本科快结束时,他申请到了 Stanford 和 UW(华盛顿大学)两个 PhD offer。UW 有 Dieter Fox,方向明确,他知道自己会做什么;Stanford 那边导师是 Fei-Fei Li(李飞飞),但当时 CS 系几乎没有人做 robotics。
他犹豫了很久,直到截止日期前一天才做决定,选了 Stanford。原因只有一个:
"UW 的确定性太高了。Stanford 那边我完全不知道会做什么,这件事情非常 exciting。"
2015 年入学,Stanford 的 CS 系主要在做 vision,深度学习刚开始兴起。他完成了几个 rotation:先跟 Silvio Savarese 做 3D 重建,再跟 Leo Guibas 做 egocentric VR 手部捕捉,最后回到飞飞组,跟同学 Yuke Zhu 做 scene graph generation。
第二年,飞飞问他要不要继续做 scene graph,他说:不要,我要做 robotics。
"I hate other people telling me what to do。只要给我绿灯,I just went full steam ahead。"
就这样,他和 Yuke、Ajay 以及另几个人,在当时的 SVL(Stanford Vision Lab)里拼凑出了一个 robotics 小组,基本上从零开始。
四、行为克隆为什么被压制了这么久
PhD 中期,2019 年的夏天,他去 DeepMind 做了暑期实习。
"那个时候 DeepMind 是 the mecca of robot learning。"
在那里,他亲眼见到 behavior cloning(BC)的效果之后大受震撼。
"I saw it with my own eyes,behavior cloning just works。"
但当时整个社区——不只是 DeepMind——都有一种"BC shame"。主流观念是:机器人应该通过强化学习自己探索,监督学习给机器人用是不上台面的事情。
"It's not politically correct to do behavior cloning。"
DeepMind 有非常多 SpaceMouse 遥操数据,BC 的效果早有苗头,但因为公司的核心叙事是强化学习,这件事被刻意压了下去。
回到 Stanford 后,他和同学 Jay 决定反其道而行之。两人三个月时间,从 C++ 学起,把 Franka 机械臂的控制、数据采集、力控遥操、BC 算法整个管道全搭了一遍,"天天凌晨三点在 Gates 楼下。"
最后的结果:一个 30 秒长的任务,把盘子从烤箱里拿出来、放东西进去、再推回去。
"是我们之前从来没有在机器人上见过的那种 behavior。虽然它不 generalize,但 it's a sign of life。"
然而当时正好碰上了疫情,没有 robot access,整个项目也就没了下文。
"如果没有 COVID,it's gonna be a completely different thing。"
他也承认,当时他们为了让论文能发出去,还是在 BC 上面加了一层额外的 novelty 包装——"为了让 reviewer 满意。"这件事他讲得很坦诚。
五、EgoMimic:第一个认真用 Meta Aria 的 robotics 项目
2023 年初,已经在佐治亚理工当上助理教授的他,开始做第一批自己主导的项目之一:EgoMimic。
出发点是:能不能直接用人类第一人称视角数据训练机器人?
最开始他们用的是 Oculus Quest 加 Leap Motion,结果 calibration 极不稳定——三个设备(头部追踪、手部追踪、摄像头)要统一到同一坐标系,误差太大,搞了几周都没搞定。
正好有合作者在用 Meta 的 Aria 眼镜,这款设备完美满足了所有需求:同时有手部关节估计、头部定位和第一人称 RGB 采集。他们拿来用,然后踩了大量坑。
"Meta 最终给我们开了一个 P0 支持,所有我们的 support request 到他们那边都是最高优先级。"
前后折腾了四五个月才真正跑通。
另一个挑战是机器人本体本身。当时没有一款机器人足够像人——双臂、肩部关节、头部视角。他就自己动手,从 Trossen Robotics 买了各种零件,自己设计、自己拼,搭出了一个双臂加躯干的机器人。
"当时我不是在教课就是在实验室搭这个机器人。"
EgoMimic 发表于 2024 年,核心验证了:用人类第一人称视角数据,通过手部姿态估计提取 action label,加上 VIO 做头部定位,可以直接作为机器人的遥操数据来训练 BC 策略。
六、人类数据的三层结构
在聊人类数据能教给机器人什么时,他把"人和物理世界的交互"拆成了三层:
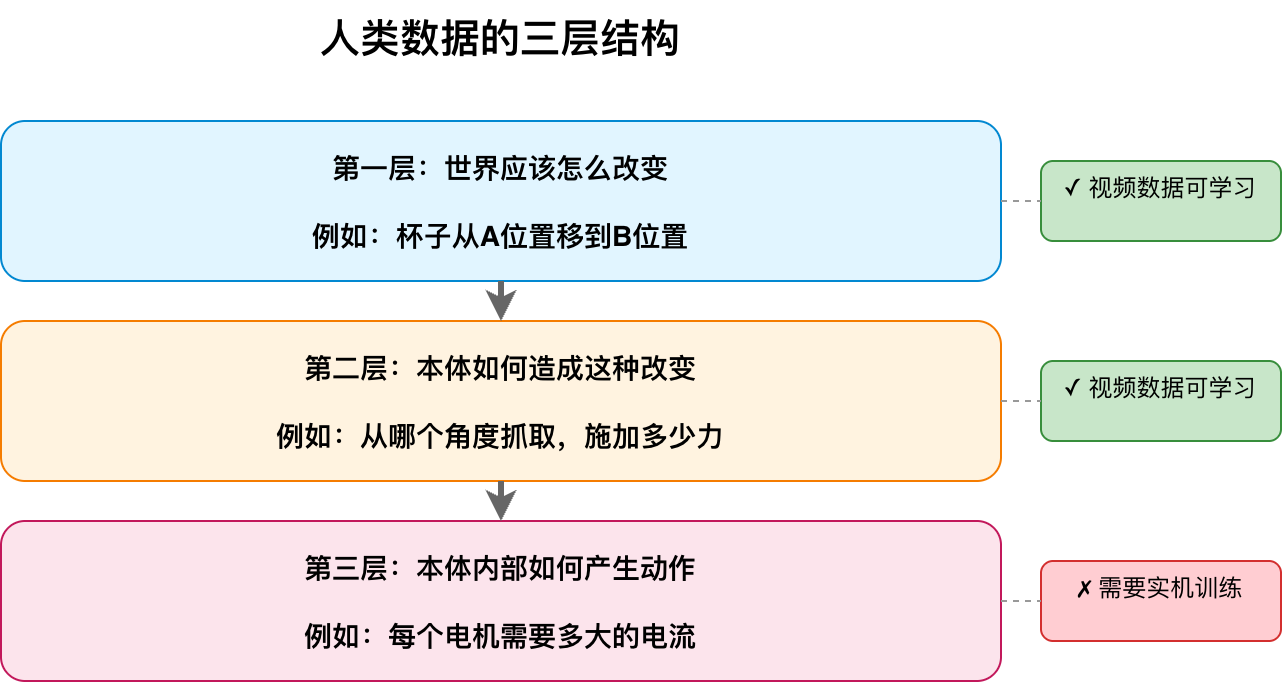
他的核心判断是:人类视频数据对第一层和第二层都有用,但第三层——本体的底层控制——没法从视频里直接学,需要通过实机训练来补。
这也是他对"直接从 YouTube 学"比较谨慎的原因。YouTube 第三人称视频的 scalability 很高,但"数据的 distribution 和机器人数据差太远,你真正能用到的数据非常少"。相比之下,有人主动去采集第一人称数据,fidelity 更高,可用性也更强。
当然他也承认,也许我们正在错过一个更大的 paradigm——就像 NLP 里的各种 subtask 没有预见到 GPT 的 next token prediction 一样。
"非常有可能。只是说,somebody 得先把 sign of life 做出来。"
七、SLAM、触觉传感器,以及哪些传感器最重要
他相当看重 SLAM(Simultaneous Localization and Mapping)在人类数据采集中的地位。原因很直接:如果你要把人当作另一种机器人,你需要知道人的手在世界坐标系里的精确位置——这需要先知道眼镜/头部的位置,而这正是 VIO(Visual-Inertial Odometry)要解决的问题。
"SLAM state of the art 在 Meta、Apple 这些 VR 公司,以及少数 driving company。Sub-centimeter level 的 SLAM 只有他们有,他们已经搞了十年了。"
他特别提到 Meta Aria 发布的城市级 SLAM benchmark,跟学术界的差距是"类似于用 VLM 跟 SIFT 比的那种"。
关于数据模态的优先级,他给了一个非正式的排名(从最重要到最不重要):
-
第一人称视频(egocentric video) -
手部姿态(hand pose) -
语言标注(language annotation) -
全身姿态 + 触觉/力(whole body pose + tactile/force) -
音频 -
嗅觉("we're not there")
他对触觉有一个底层判断:
"所有 agent 本质上都是一个 force exertion engine,给世界产生力是你存在的意义。"
但触觉传感器现在太分散,光学的、压感的、电阻的、磁场的,各家的 property 完全不同,没有像 RGB 摄像头那样统一的标准化表示。所以他认为很有可能最终我们会用 wrist camera(手腕摄像头)来代替大部分触觉的功能。
"Riding on a beat-up car,but the car's gonna take us somewhere。"
八、UMI、遥操数据、人类数据,三条路的未来
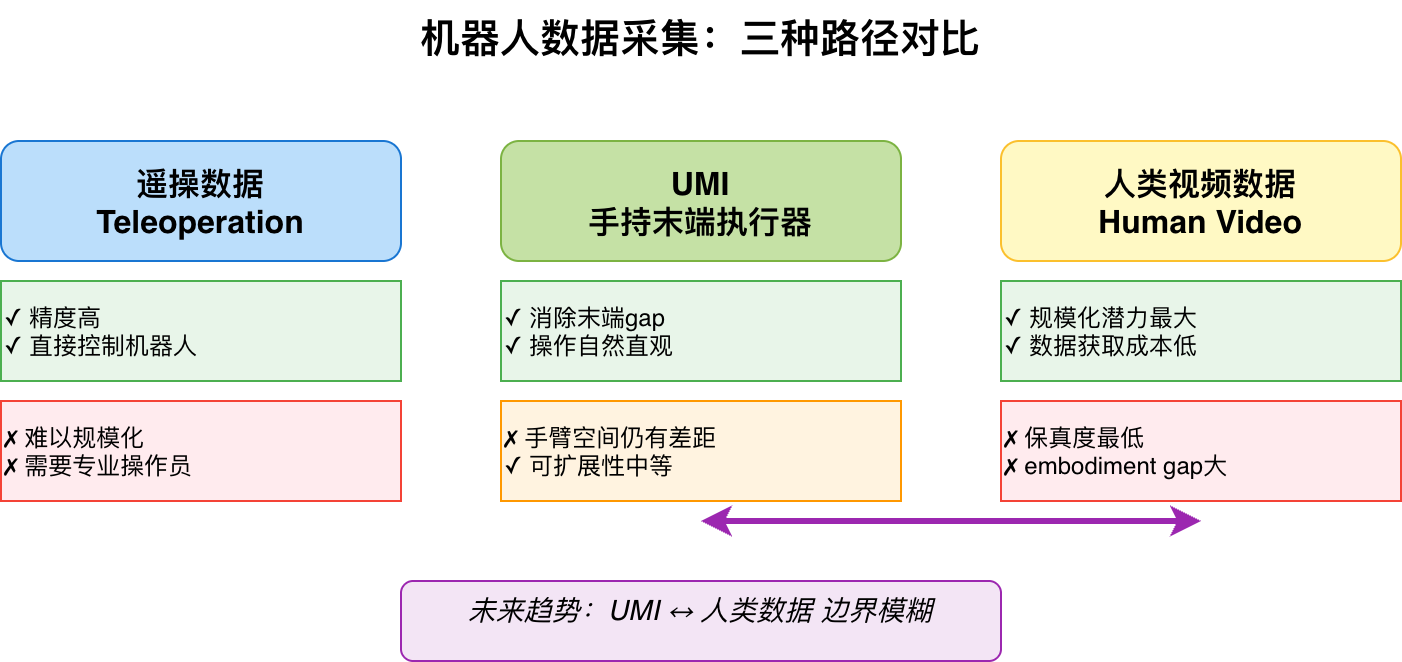
他梳理了目前机器人数据采集的三条主要路径:
-
遥操数据(Teleoperation):操作员用设备控制机器人,精度高,但 scale 难 -
UMI(Universal Manipulation Interface):手持一个连接摄像头和状态估计模块的 gripper,手部操作数据可直接用于机器人,embodiment gap 在末端执行器层面几乎消失,但手臂的操作空间仍然有差距 -
纯人类视频数据:理论 scalability 最高,但 fidelity 和可用性最低
他的判断是:
"最后 UMI 和 human data 会变得难以区分。"
现在已经有一些公司(他提到 Generalist 系列)在把 fingertip 传感器直接装在人手上,只和一个摄像头的差别越来越小。
他认为真正限制无指灵巧手(dexterous hand)数据迁移的,不是数据采集问题,而是机器人硬件:大多数机械臂的控制器响应速度和人手差太多。
"我现在能看到唯一 get it right 的就是 Generalist,他们的 controller 做得非常好。"
九、机器人的 GPT-3 时刻
"如果大语言模型的崛起来自互联网上沉淀的海量人类语言数据,那机器人是否也存在一种同样关键的数据?"
这是整期播客的核心问题。他的回答是:那个数据就是人类操作数据——人拿起杯子、打开抽屉、跟另一个人互动时在物理世界留下的痕迹。
他对最终目标的描述很直接:
"I want to behavior clone a human。一个在物理层面 indistinguishable from humans 的机器人——talk like a human,behave like a human,interact like a human。"
要做到这件事,需要多少数据?
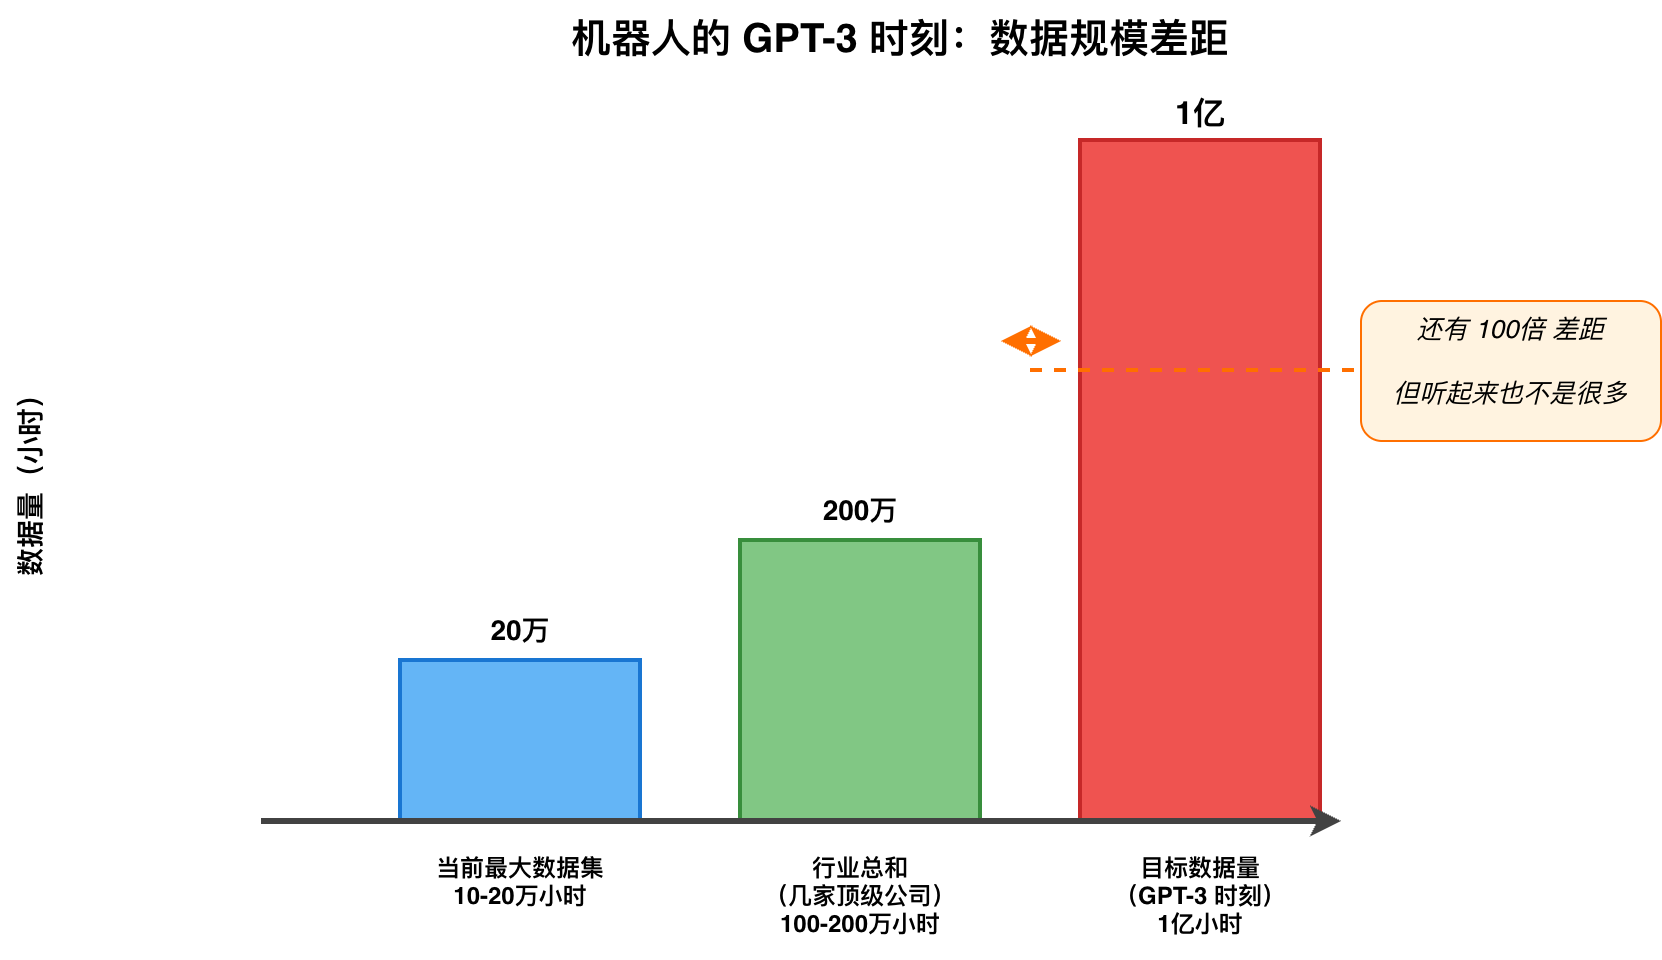
他估计大约是一亿小时。目前行业里最大的数据集大概在 10 万到 20 万小时量级,如果把几家最大的公司凑在一起,可能能凑出一到两百万小时的高质量数据。
"所以还有 100 倍的差距。但听起来 100 倍也不是很多。"
他把现在整个行业的状态比喻成"一辆高速前行的火车,前面有几个 lab 在疯狂搭铁轨,后面所有的资本往车里加油"——火车跑得太快,铁轨根本来不及铺。
他最大的担忧不是技术,而是节奏:在大家失去信心之前,能不能把 sign of life 持续推进?
"I'm hopeful。我觉得我们能在大家失去信心之前把这件事情做成。"
十、关于 full stack,以及他的 lab 文化
他反复强调:robotics 是一个系统问题,不能分功能解决。
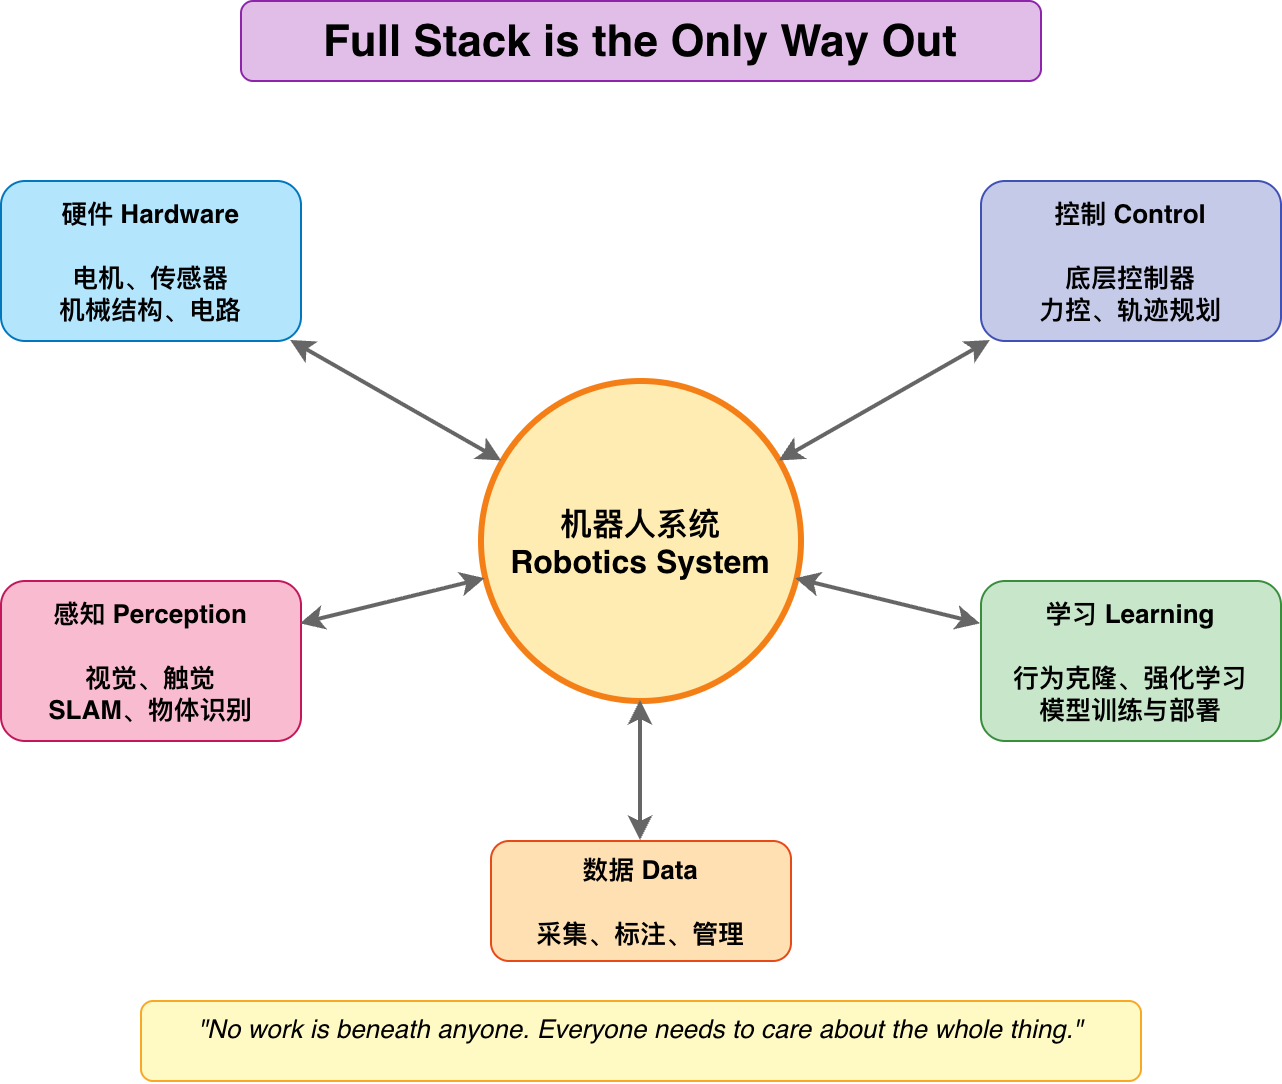
"Full stack is the only way out。"
这种判断来自于他在 Zoox(自动驾驶公司)的实习经历——那个暑假他发现自动驾驶已经退化成了一个 vision 问题,每个人只管自己那一块的 benchmark。
"我觉得这件事情很无聊,而且我们真的在聊的是一个 robotics 问题,不是一个 vision 问题了。"
他在 lab 里有一份 culture doc,其中最重要的几条是:
-
讨厌分工,everyone needs to care about the whole thing -
No work is beneath anyone(机器人的电机坏了,他直接下场自己焊) -
Full stack or nothing:选学生最基本的一条是"你不能讨厌硬件"
他也坦言,某种程度上他是个很难被 manage 的人:
"I will be a terrible student。I just don't want other people telling me what to do。"
所以他享受教职最大的原因,并不是学术本身,而是自由:"这件事情可以让我干我自己有兴趣的事情。"
十一、给年轻人的建议
采访快结束时,他被问到了几个关于建议的问题,他的回答相当具体:
关于 taste(品味)的培养:
不要只看一个研究者做了什么,要理解他为什么做。
"你是在学习他的 gradient,不是在学习他的 transaction。"
关于 robotics 的坑:
"Treat robotics like robotics。不要觉得控制不是 robotics,硬件不是 robotics,planning 不是 robotics。很多人把方法和问题混淆在一起——你要解决的是一个问题,不是一个方法。"
关于 2026 年读 PhD:
比十年前难了。
"现在这个 FOMO 情绪太高了,winner takes all 的感觉太强,大家没有耐心培养自己的 taste。"
但工具变多了,Claude Code 这些东西让执行变得更快。
"专注变难了,但如果你 choose correctly,it's much easier to do something。"
尾声:时间胶囊
节目最后,主持人请他留下一段话,作为"时间胶囊"——可能五年、十年甚至二十年后被回看:
"能够参与在一个能改变世界的领域,在正确的时间在正确的地方,是一件非常幸运的事情。
我并不是一直想改变世界才导致我在这里——大部分情况下,我只是做自己想做的事情。
我觉得绝大部分人,做自己想做的事情,会让你的 career 和生活变得更容易。也没有那么多脱离大部队的后果。
所以,勇敢地做自己想做的事,不要有那么多包袱。"
采访时间:2025 年,视频来源:B 站[1]
整理者注:EgoMimic 论文见 arXiv:2410.24221[2];UMI 论文见 arXiv:2402.10329[3]
引用链接
[1]B 站: https://www.bilibili.com/video/BV1usRgBEESe/
[2]arXiv:2410.24221: https://arxiv.org/abs/2410.24221
[3]arXiv:2402.10329: https://arxiv.org/abs/2402.10329
https://mp.weixin.qq.com/s/M_ShOWq2vNTKY9-XDXIVoA
2025年,人形机器人产业迎来爆发拐点。特斯拉Optimus量产在即,华为、宇树等企业加速技术突破,行业正从“实验室研发”向“规模化落地”跃迁为打通产业链上下游协作壁垒,艾邦机器人正式组建"人形机器人全产业链交流群",覆盖金属材料、复合材料、传感器、电机、减速器等全硬件环节,助力企业精准对接资源、共享前沿技术!
扫码关注公众号,底部菜单申请进群