

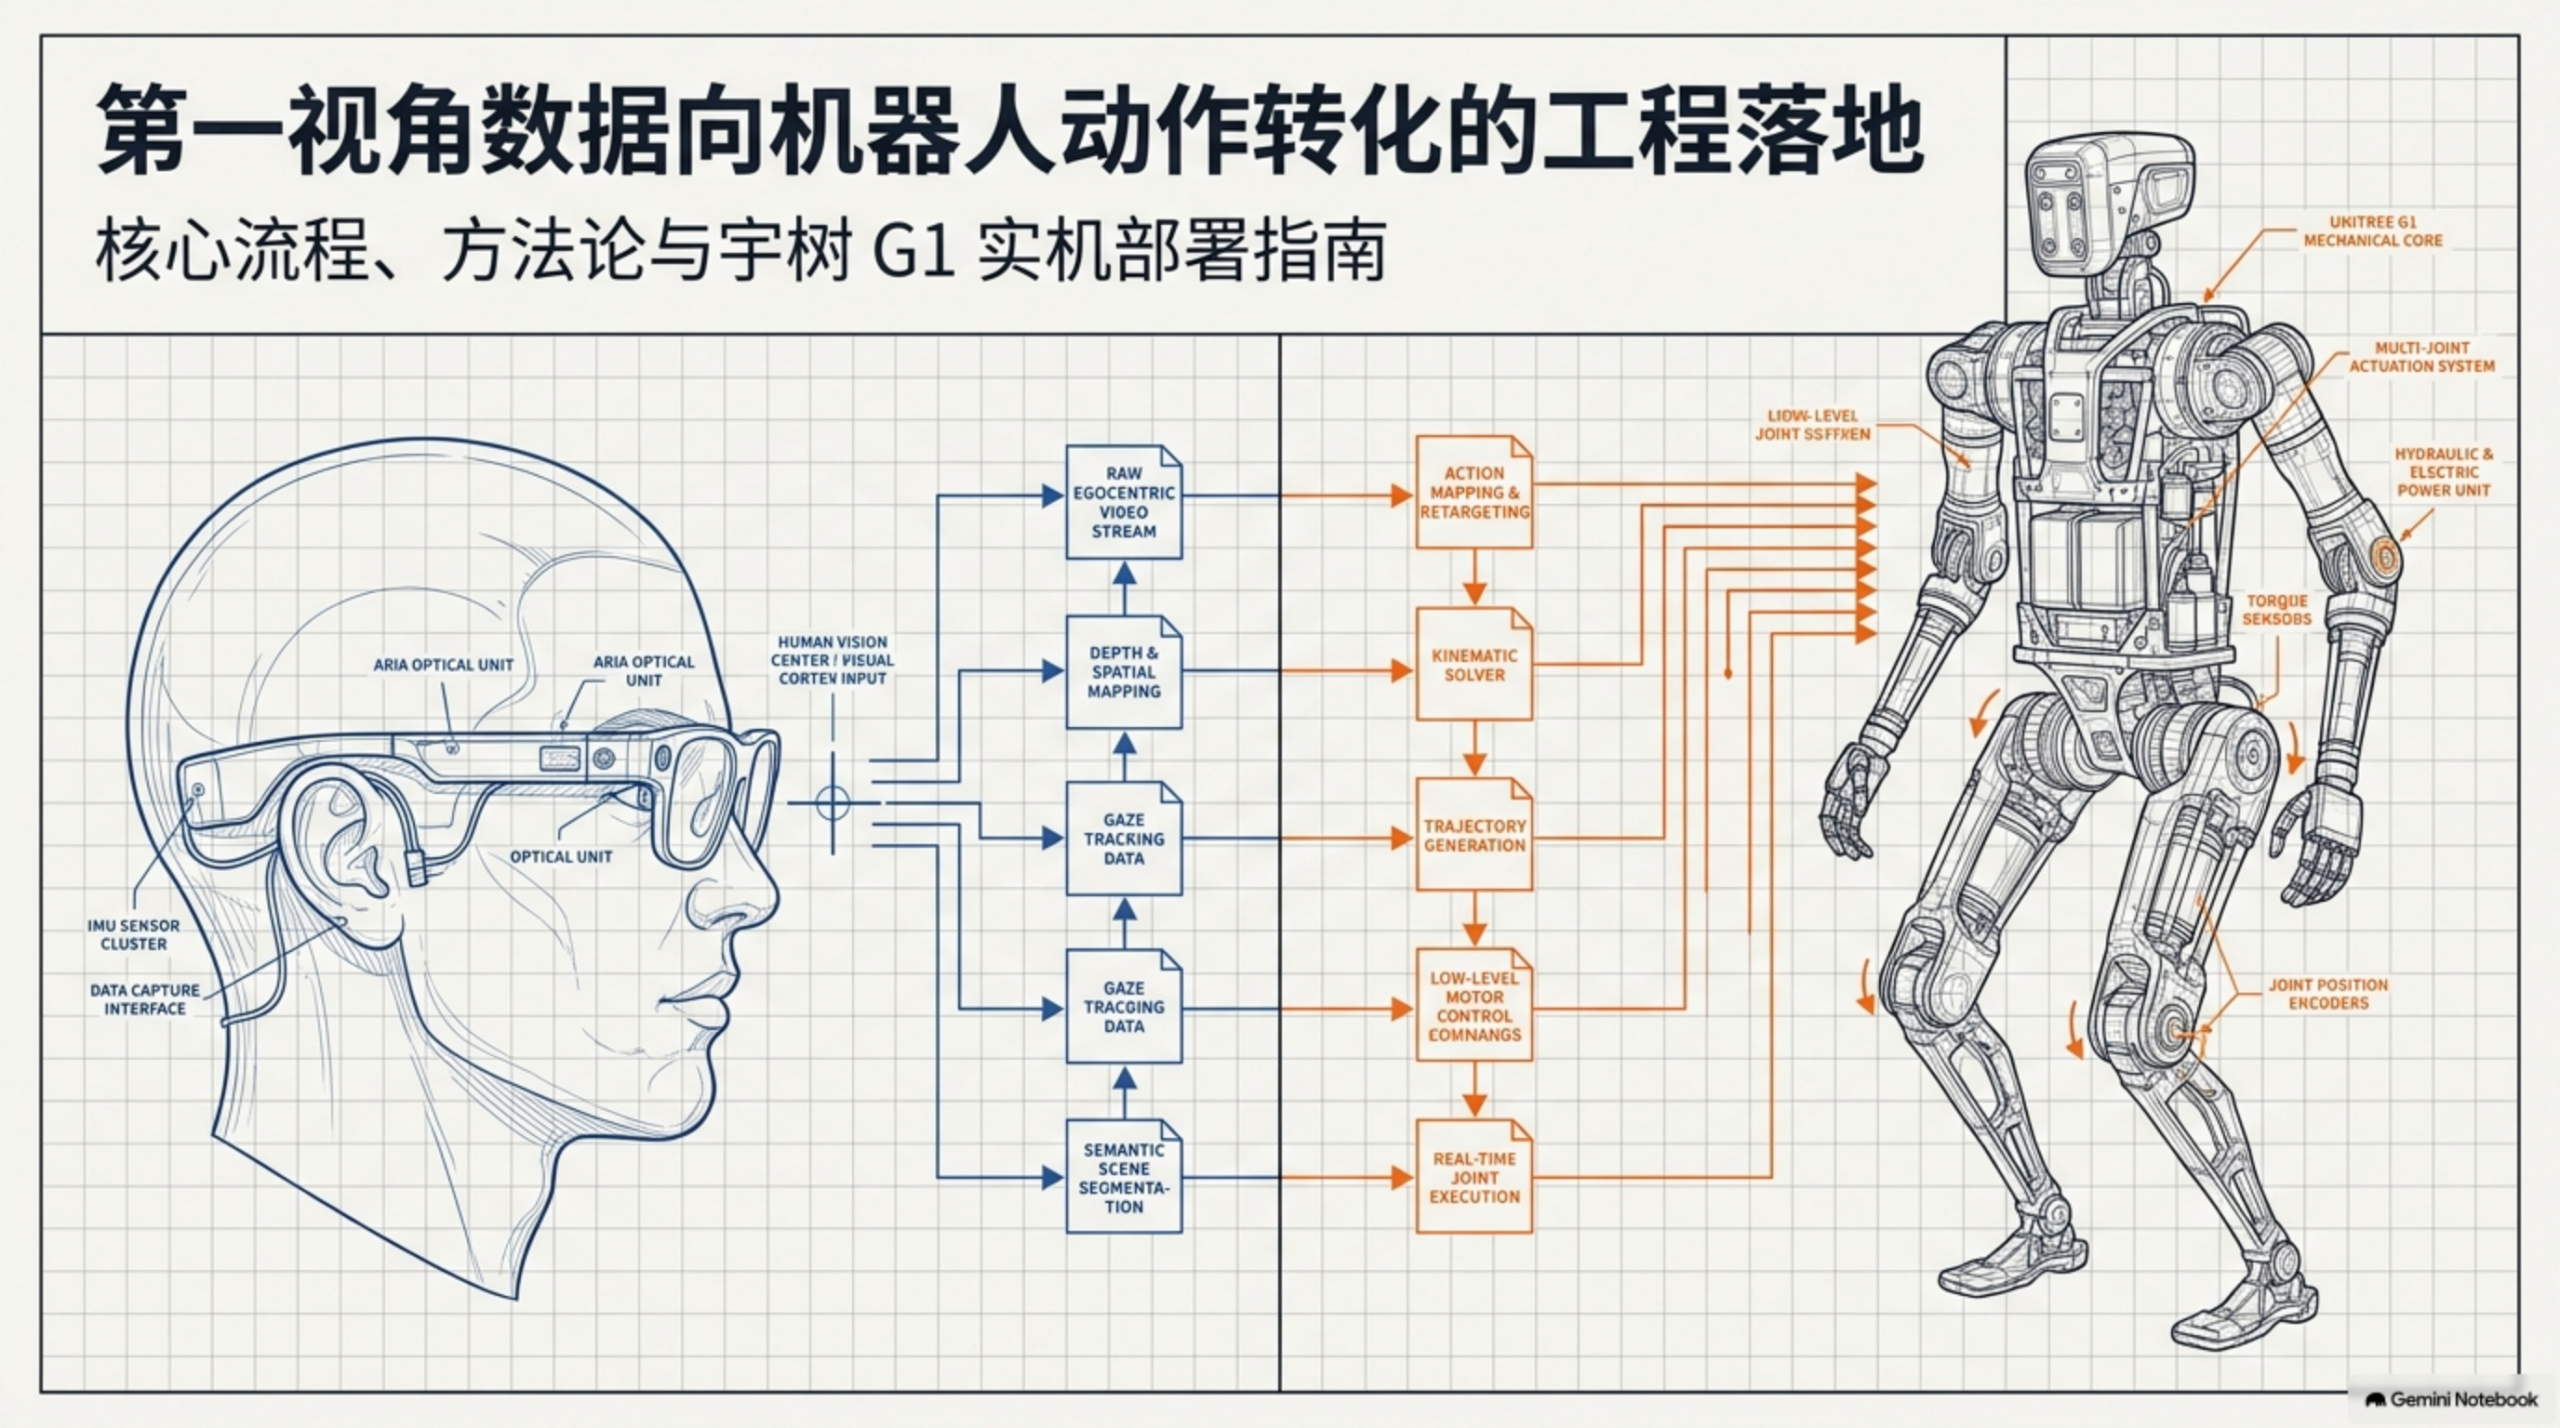
▲ 从一副眼镜到一台人形机器人,中间隔着一条完整的工程管线
2026 年 4 月,Georgia Tech 联合 Stanford、UCSD、ETH Zurich、Meta 等机构发布了 EgoVerse:2087 位采集人戴着智能眼镜或一部手机,在 240 个场景里干了 1362 小时的活,产出约 8 万条操作数据,覆盖 1965 种任务。整个采集现场,没有一台机器人。
传统路线是什么样的:一台人形机器人上百万,遥操作采一条数据约 62 秒,操作员被拴在实验室里,采一小时综合成本数百美元。而人自己干活,一条约 40 秒,摘下眼镜就能休息。
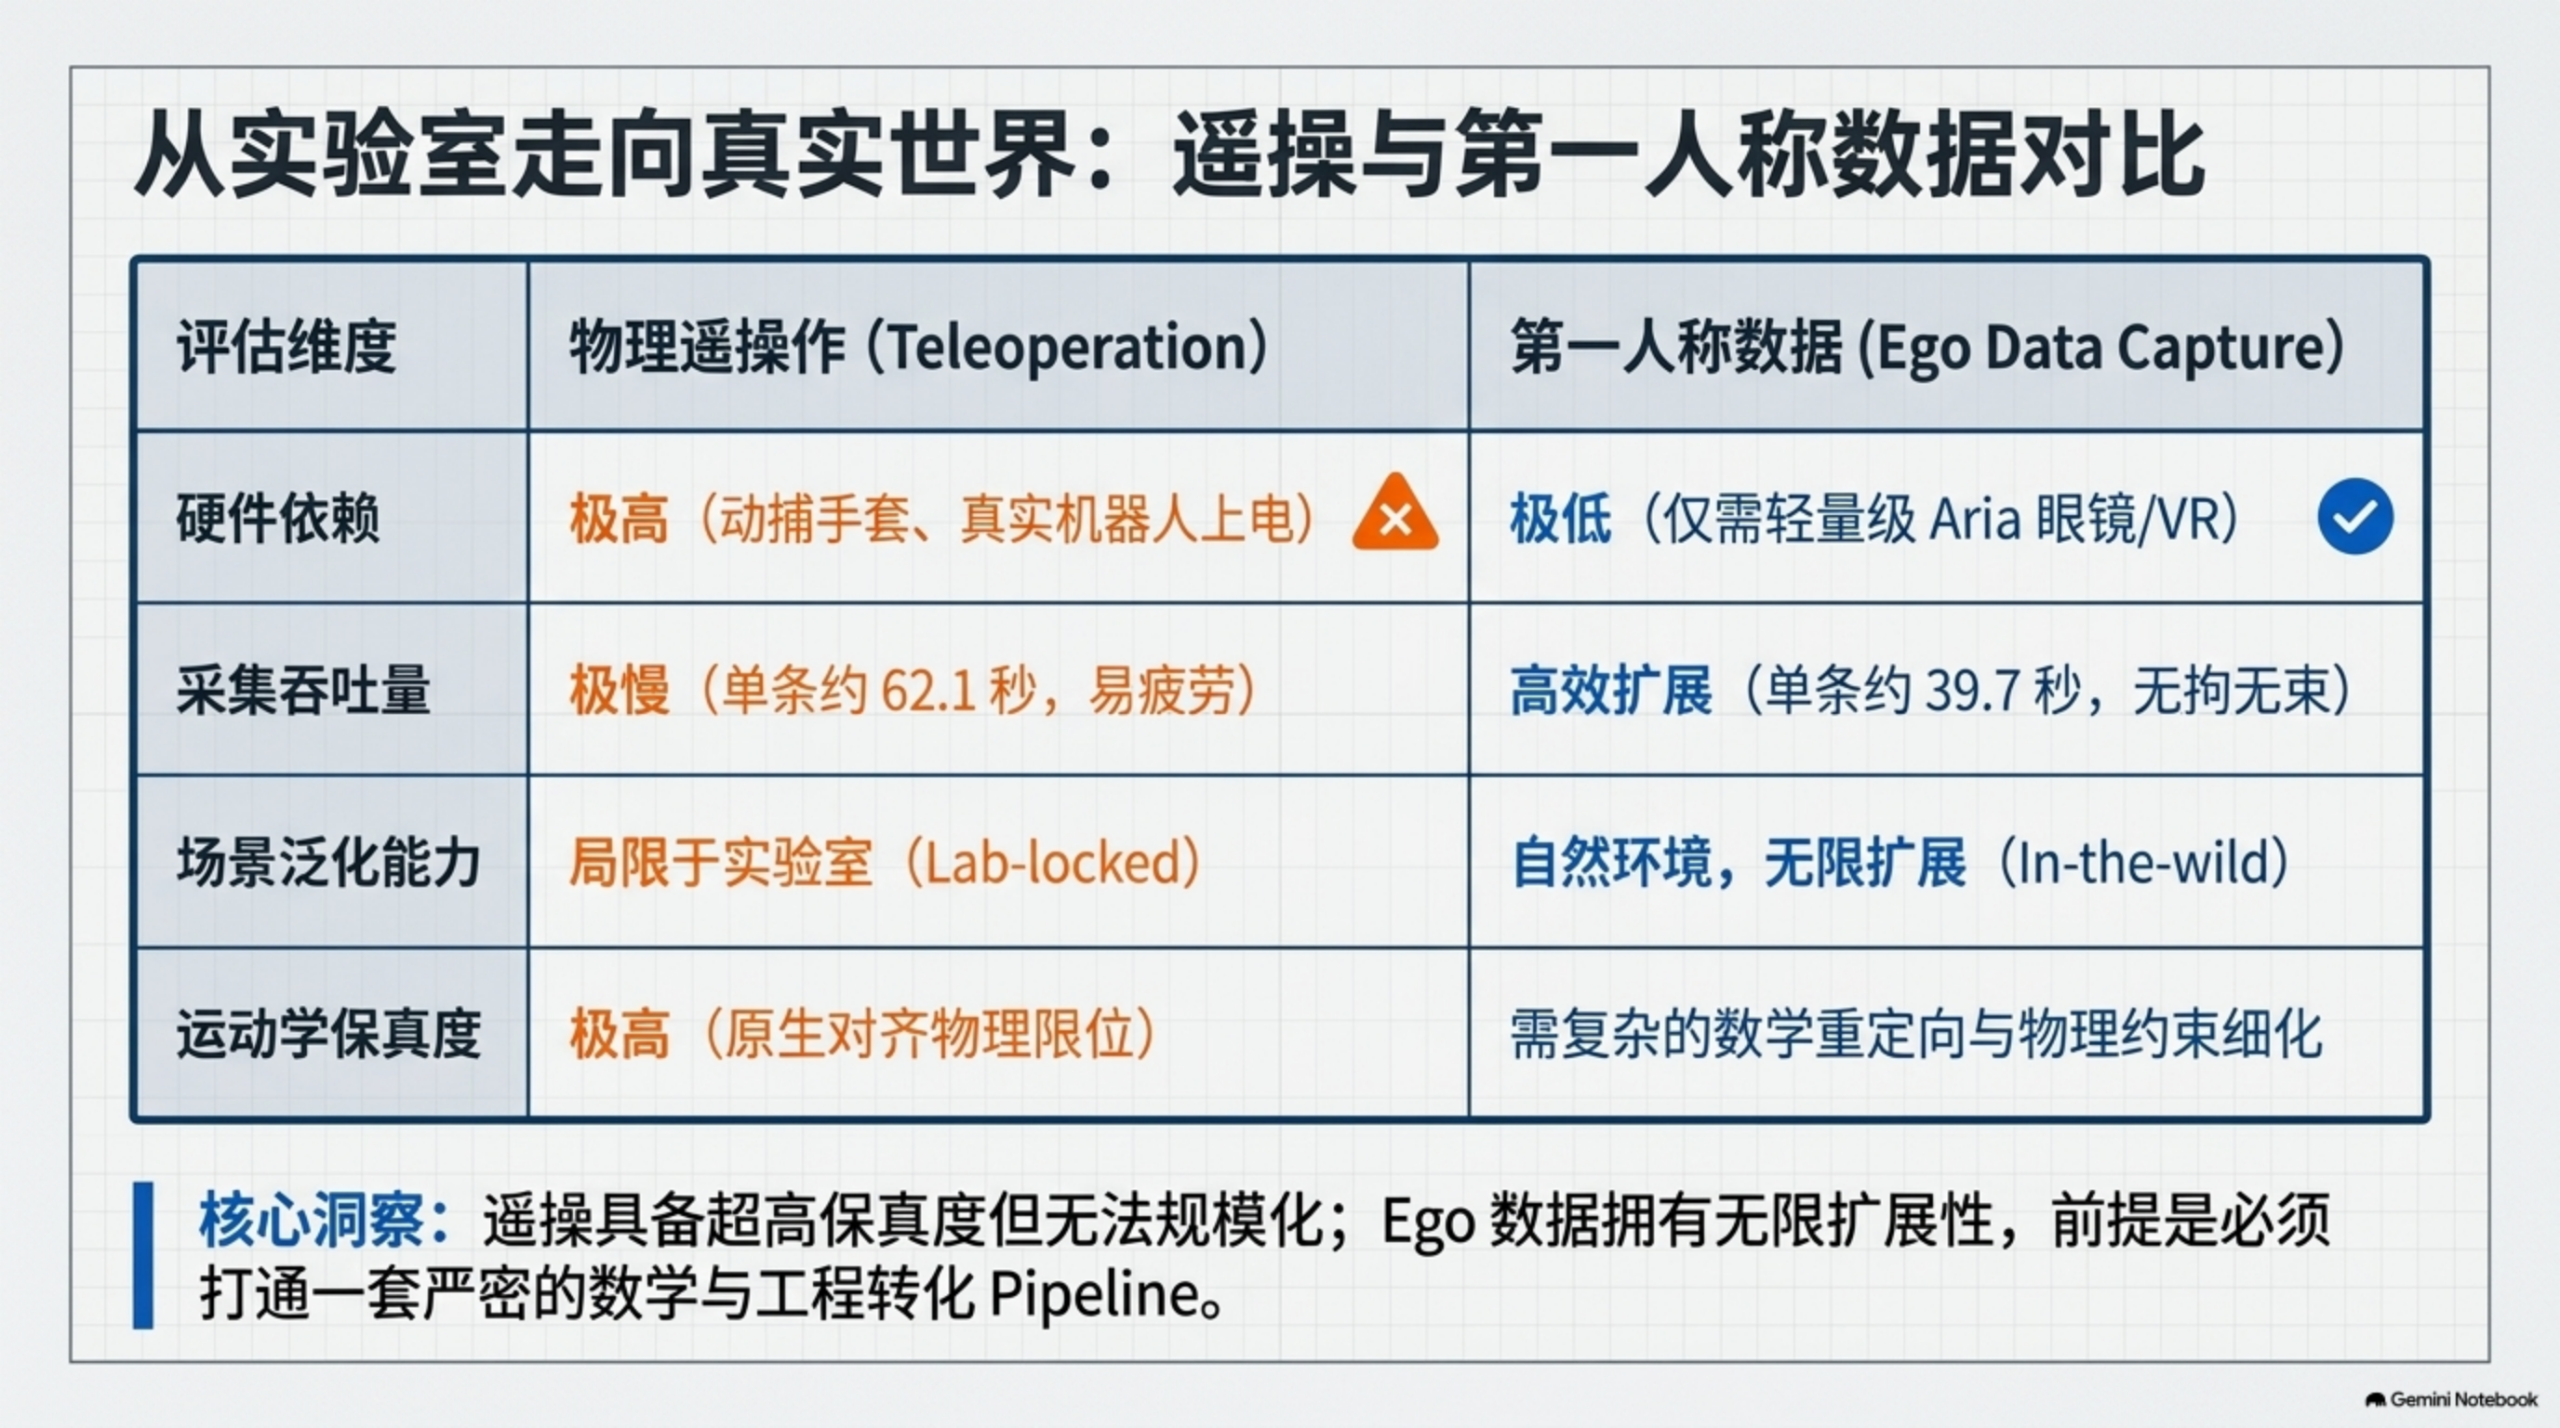
▲ 遥操作保真度高但没法规模化,Ego 数据能规模化但需要一条转化管线
这就是当下越来越多人押注的路线:无机器人采集——数据靠人采;无本体表示——数据不绑定任何一款机器人;最后回放——先在仿真里验证,再上真机执行。
但有个问题绕不过去:人干活的视频,凭什么能教机器人干活?这篇就把中间这条管线完整拆开,每一道工序都讲到。
一、先说结论:视频不能直接放给机器人
Ego 视频记录的是"人在第一视角下做了什么",机器人需要的是"自己的关节角度、末端位姿、夹爪开合度"。两者之间隔着两道鸿沟。
第一道是视觉分布鸿沟。人手和金属夹爪长得完全不一样;人眼视场和机器人相机视场对不上;身高不同,连看桌面的角度都不同。模型在人的画面里学到的东西,换到机器人的画面里就失灵。
第二道是运动学具身鸿沟。人手 25 个自由度,市面平行夹爪普遍只有 3 个;人靠肌肉肌腱发力,机器人靠电机和谐波减速器。力量传递方式、接触稳定性、动力学特性,全都不一样。
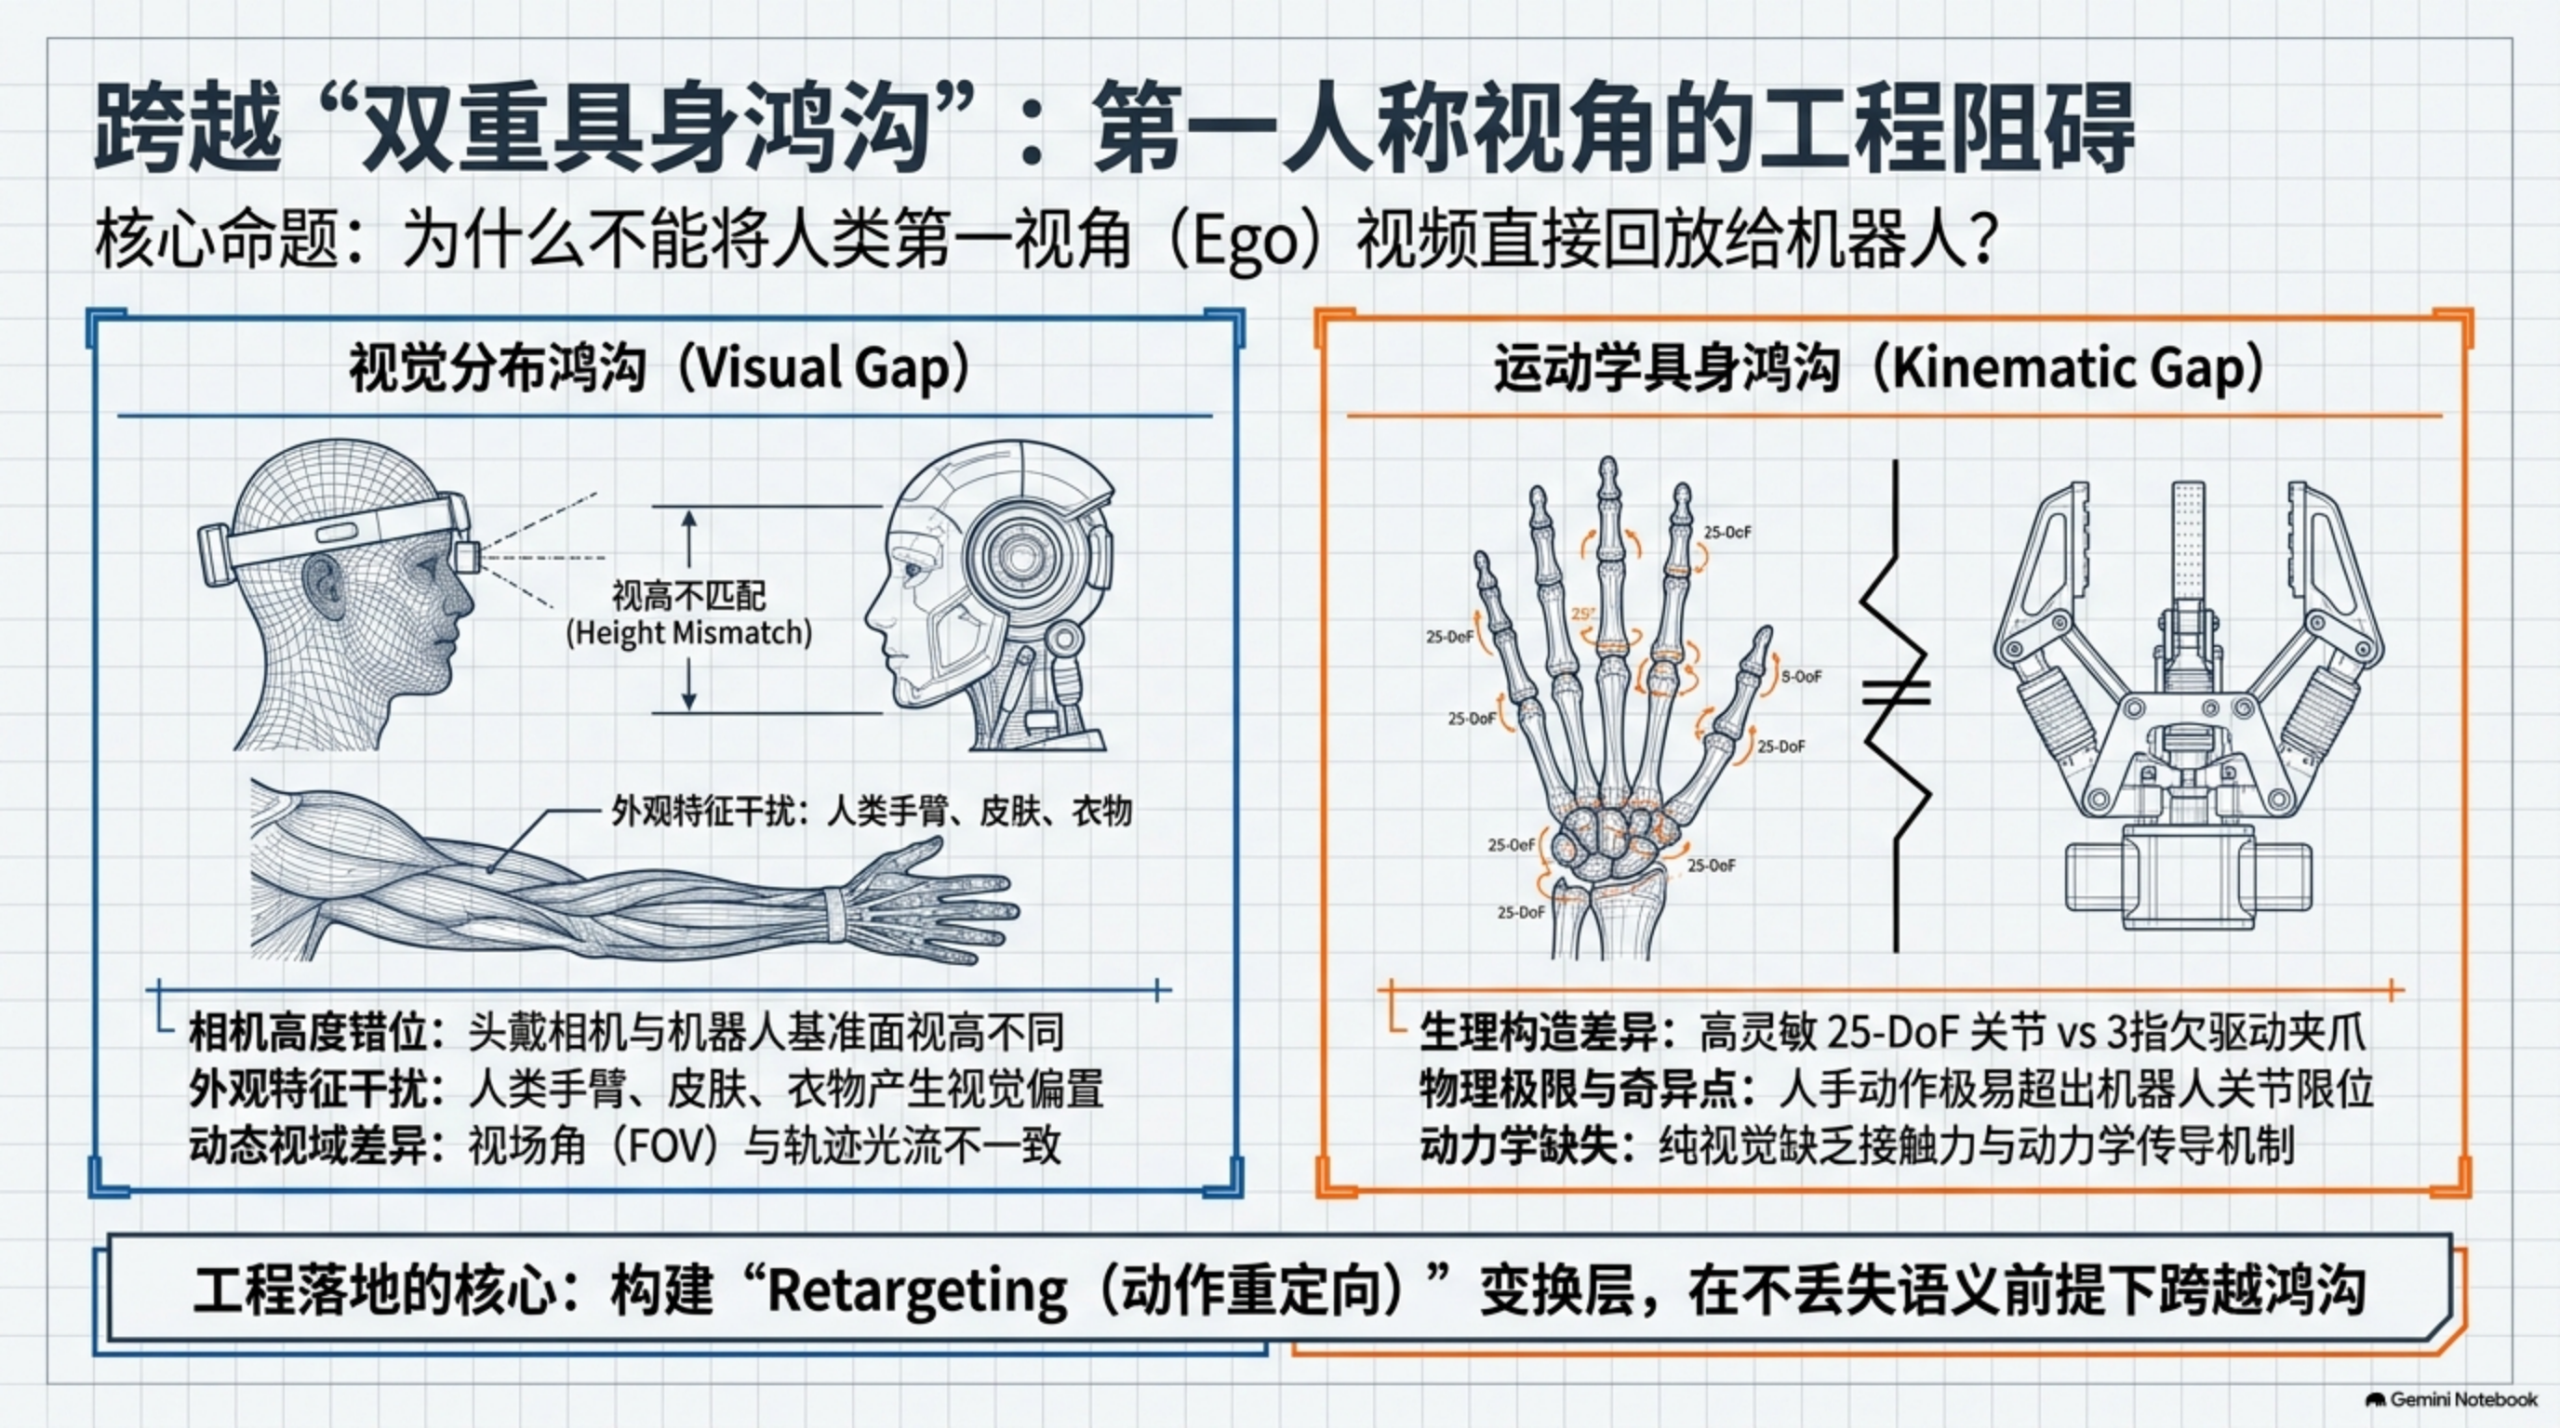
▲ 视觉分布鸿沟与运动学具身鸿沟,是整条管线要跨越的两堵墙
所以中间必须有一个 Retargeting(动作重定向)层,在不丢失语义的前提下,把跨越两道鸿沟的变换做干净。整条管线,都是在伺候这一层。
二、全景:无本体数据工厂的四段流水线
第一段,Ego 采集。硬件是 Aria 眼镜、VR 头显或者一部手机,输出同步的 RGB、音频、IMU 和 SLAM 位姿。
第二段,视觉与动作对齐。工序包括视觉去人性化、坐标转换、相对轨迹提取,目标是把五花八门的视频统一到统一的动作空间。
第三段,策略共训。Ego 数据和少量遥操作数据按配比混合,做中期融合,把视觉先验锚定进物理空间。
第四段,物理部署与回放。落到宇树 G1 这类本体上,由 VLA 大模型输出全身控制指令。
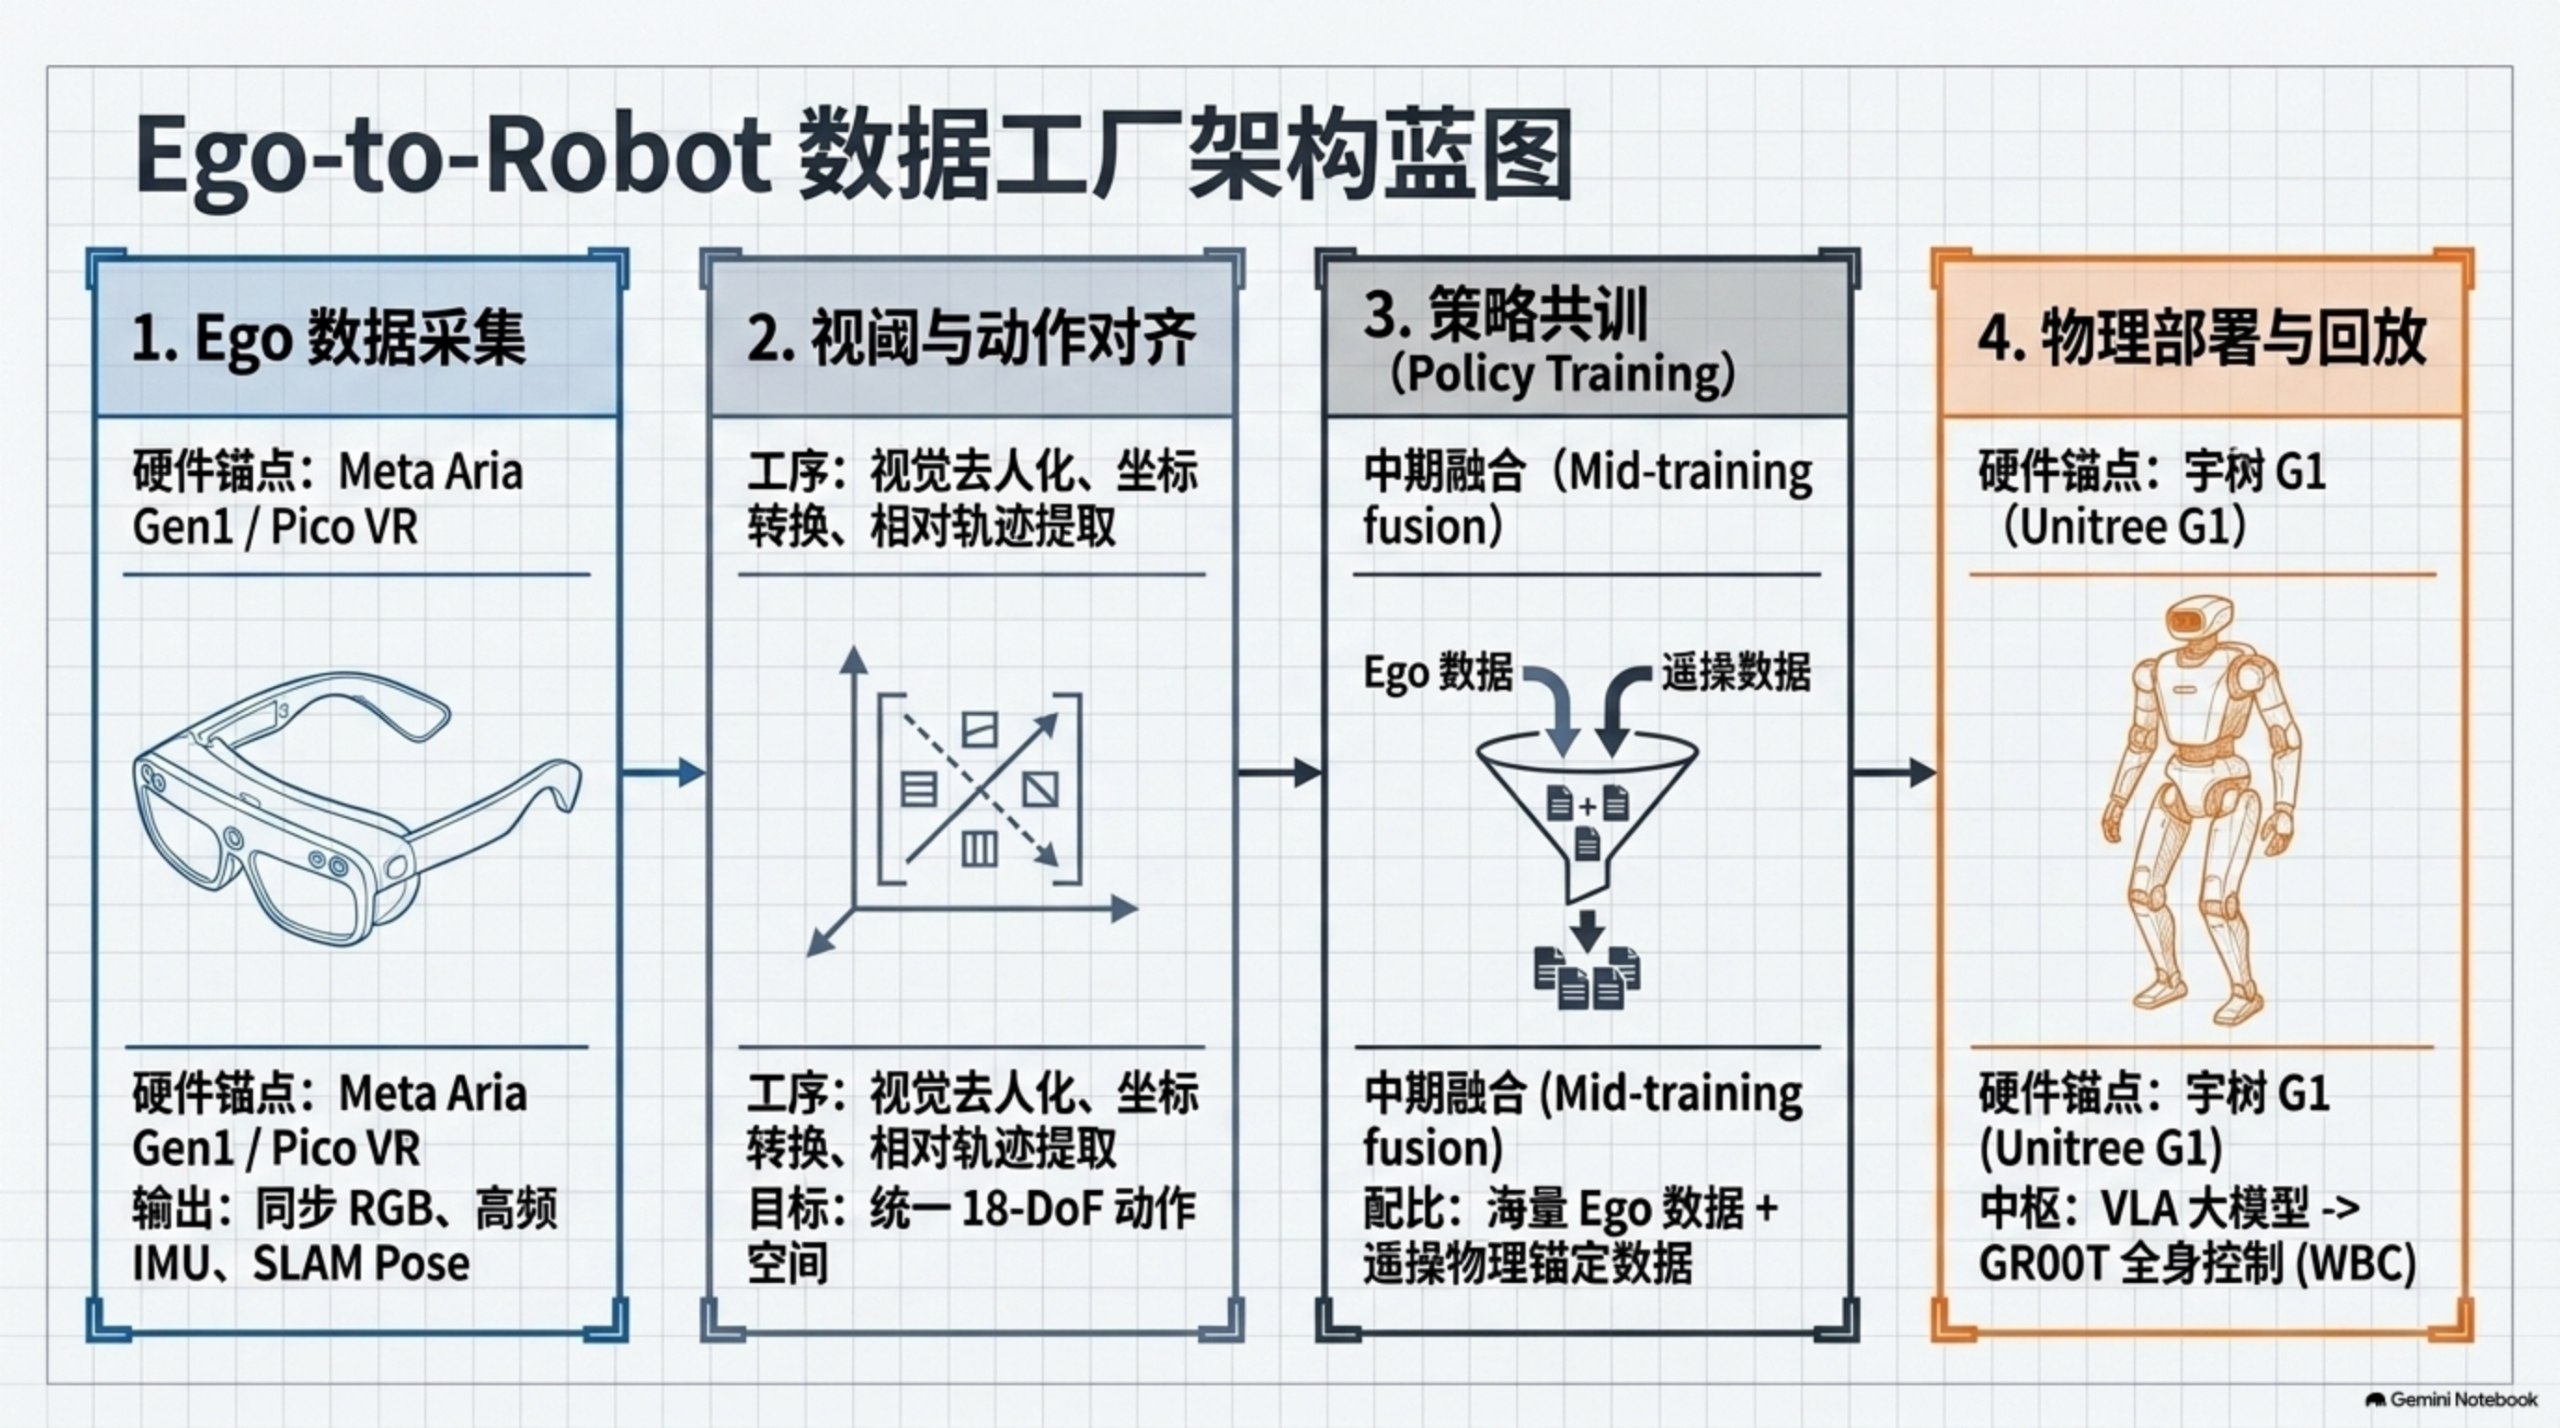
▲ 采集、对齐、共训、回放,四段构成一条数据工厂流水线
EgoVerse 在这套架构底下加了一层基础设施:EgoDB。原始数据进 S3,元数据进 Postgres,Ray 集群夜间跑处理管线,第二天醒来数据就是训练就绪的。他们管这个叫 living dataset——数据集是活的:今天进一批手机拍的视频,明天进一批 Aria 眼镜的,处理后汇进同一个池子,按任务、场景、本体任意检索。
三、三级转化阶梯:视频要爬三层才能变成动作
Level 1 是原始 Ego 数据:RGB、深度、IMU、统一时间戳。训练视觉模型有用,但对机器人毫无意义——机器人没法执行一段视频。
Level 2 是人体运动状态:3D 手部姿态(21 或 26 自由度)、6 自由度头部位姿、基于 SLAM 的全局定位。这一层是转换的枢纽。
Level 3 才是机器人可执行动作:18 维输出,双臂相对位姿、步态速度、夹爪开合。到了这一层,机器人才看得懂。
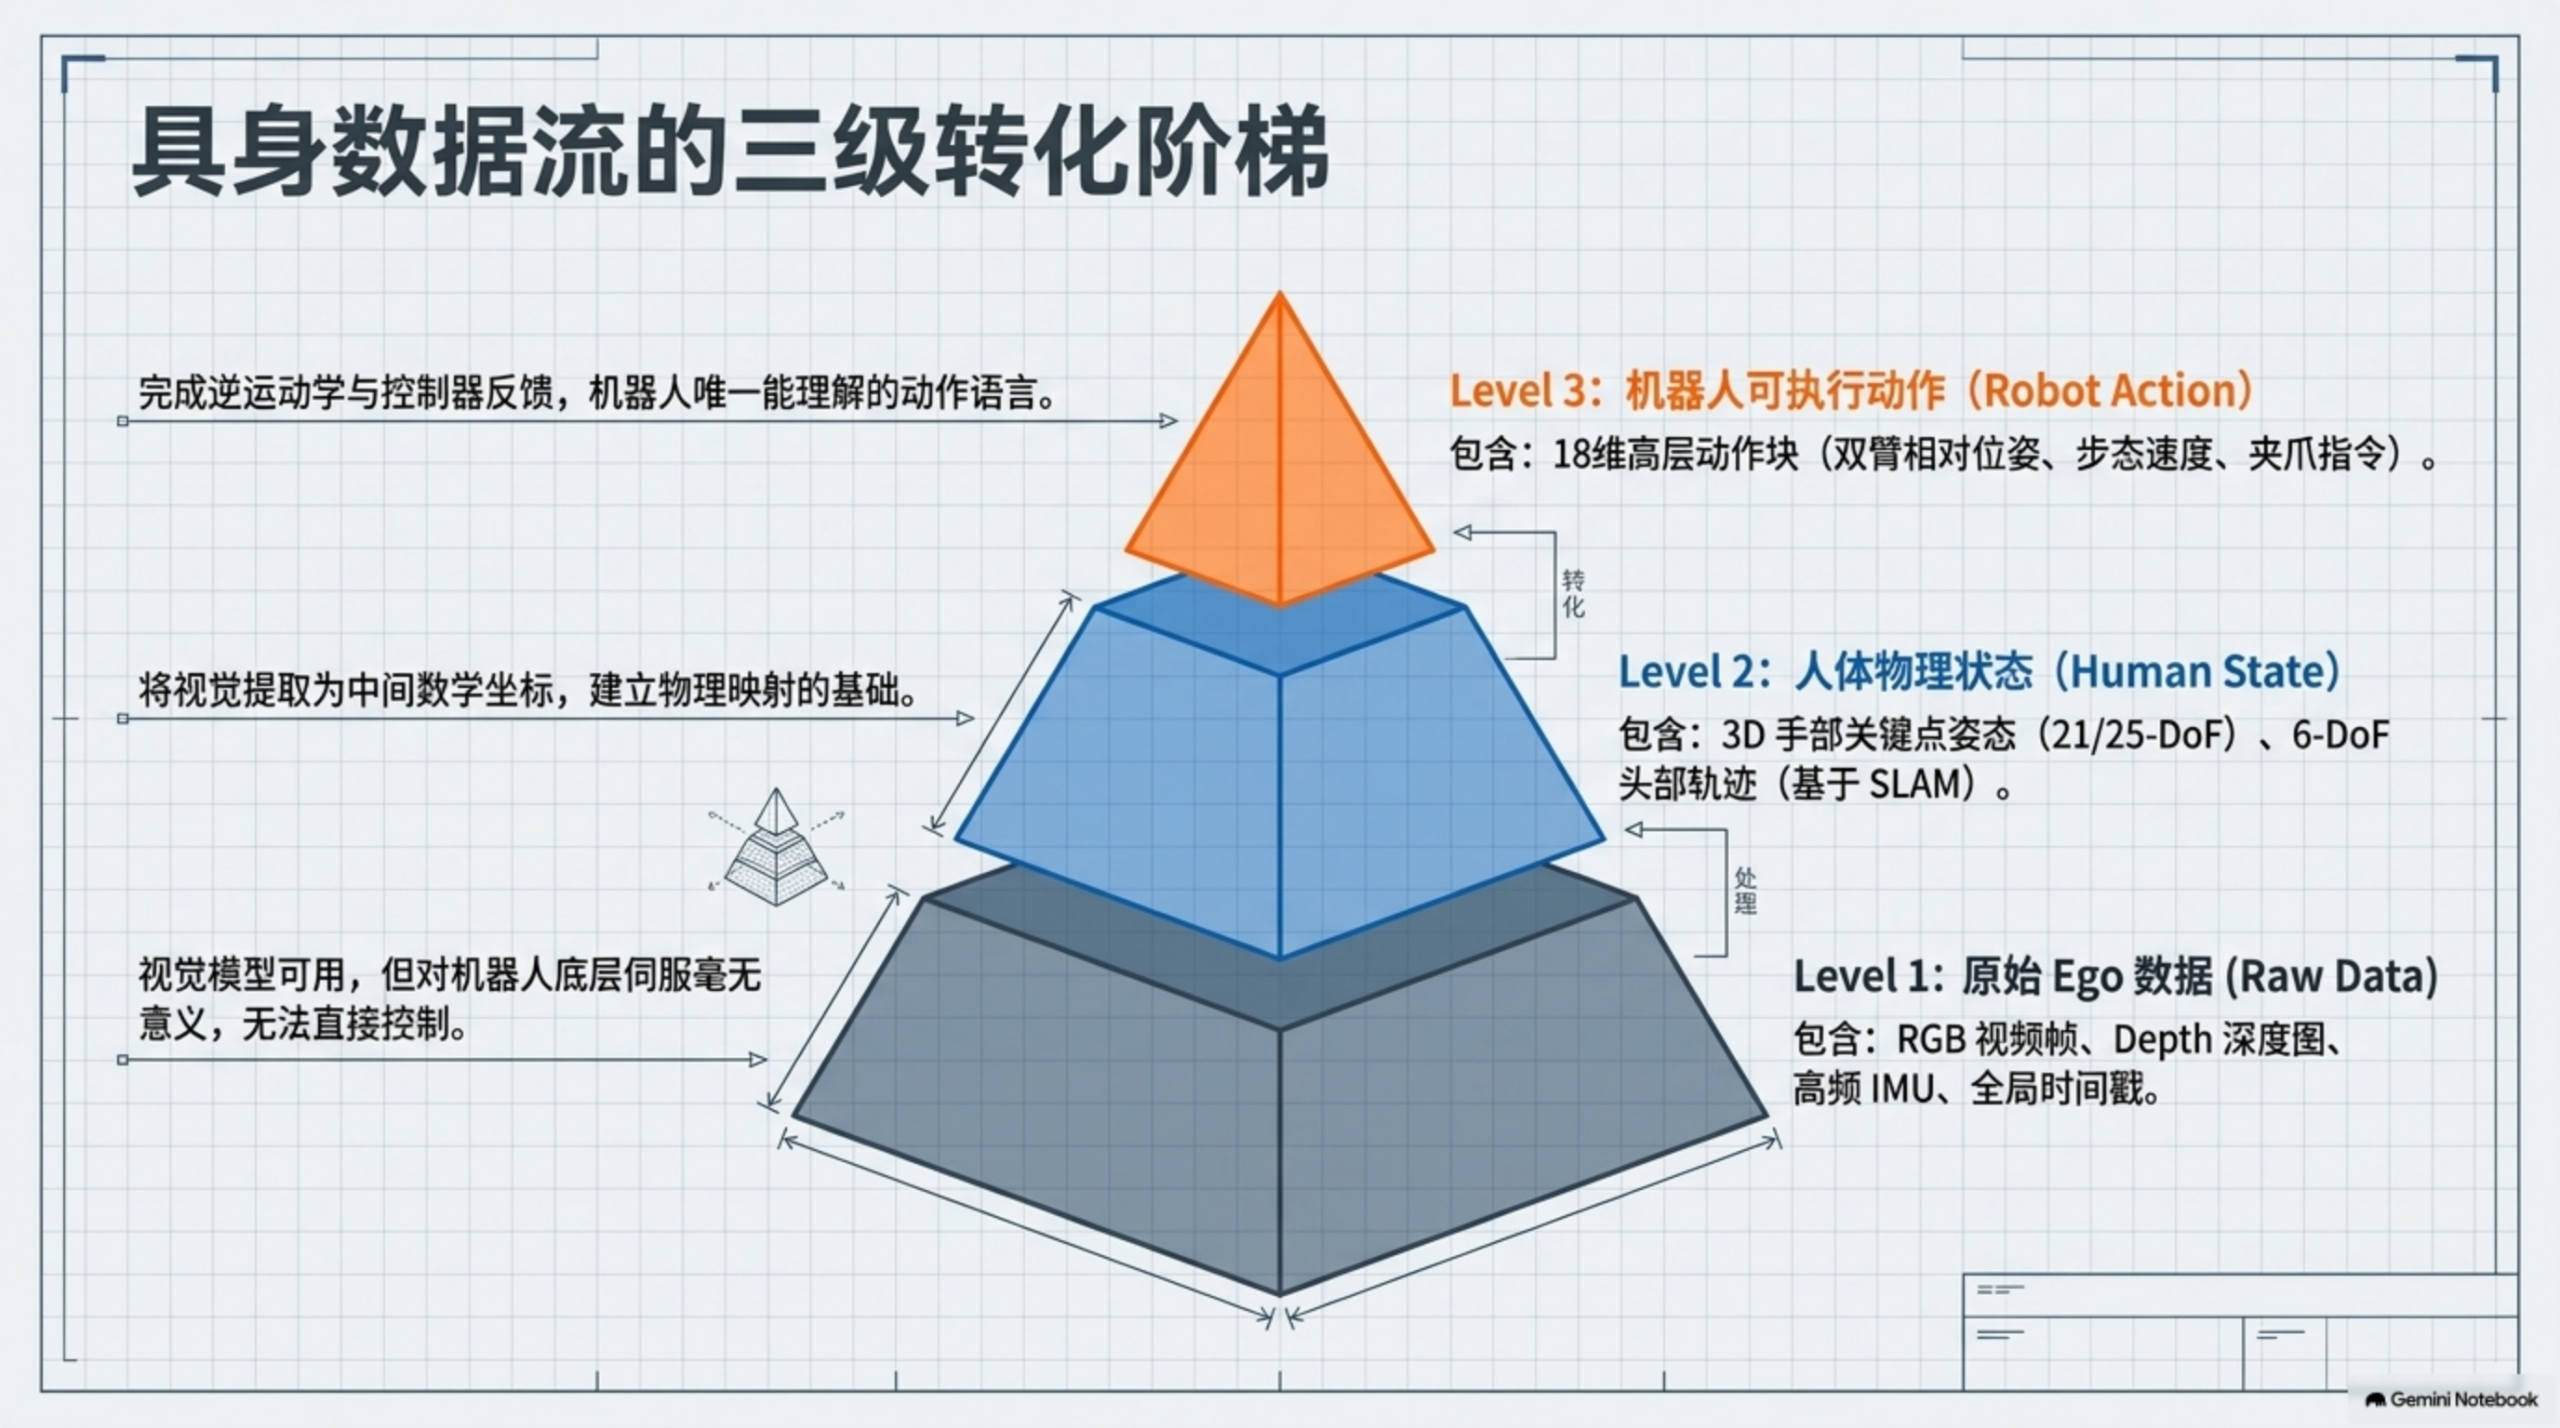
▲ 视觉提供可用性,但机器人只认 Level 3 的动作语言
EgoVerse 的做法印证了这个分层。不管数据来自 Aria 眼镜、头带手机还是工业自研的双目设备,最后都压成同一个规范表示:第一视角视频,加每只手 21 个关键点,加 6 自由度相机位姿。采集端五花八门,落到数据层只有一种格式。
这就是"无本体"的字面意思——数据停在 Level 2,不偏向任何一台机器人。至于喂给谁,是下游的事。
四、视觉对齐:把人擦掉画上机器人,或者干脆不改画面
第一条路线是视觉编辑,三步走。
第一步,拆解与修补。SAM2 提取手部和前臂的掩码,LaMa 图像修复算法把人手数字擦除、回填背景,画面变成"没人碰,东西自己动了"。
第二步,深度重投影。用 MoGe 这类模型把 2D 像素推至 3D 点云,施加空间平移,对齐到 G1 头部相机的真实高度。
第三步,虚拟夹爪渲染。机器人做正向运动学(FK),在原图中合成机械臂,再按深度做遮挡处理——夹爪伸到杯子后面时,会被杯壁挡住。
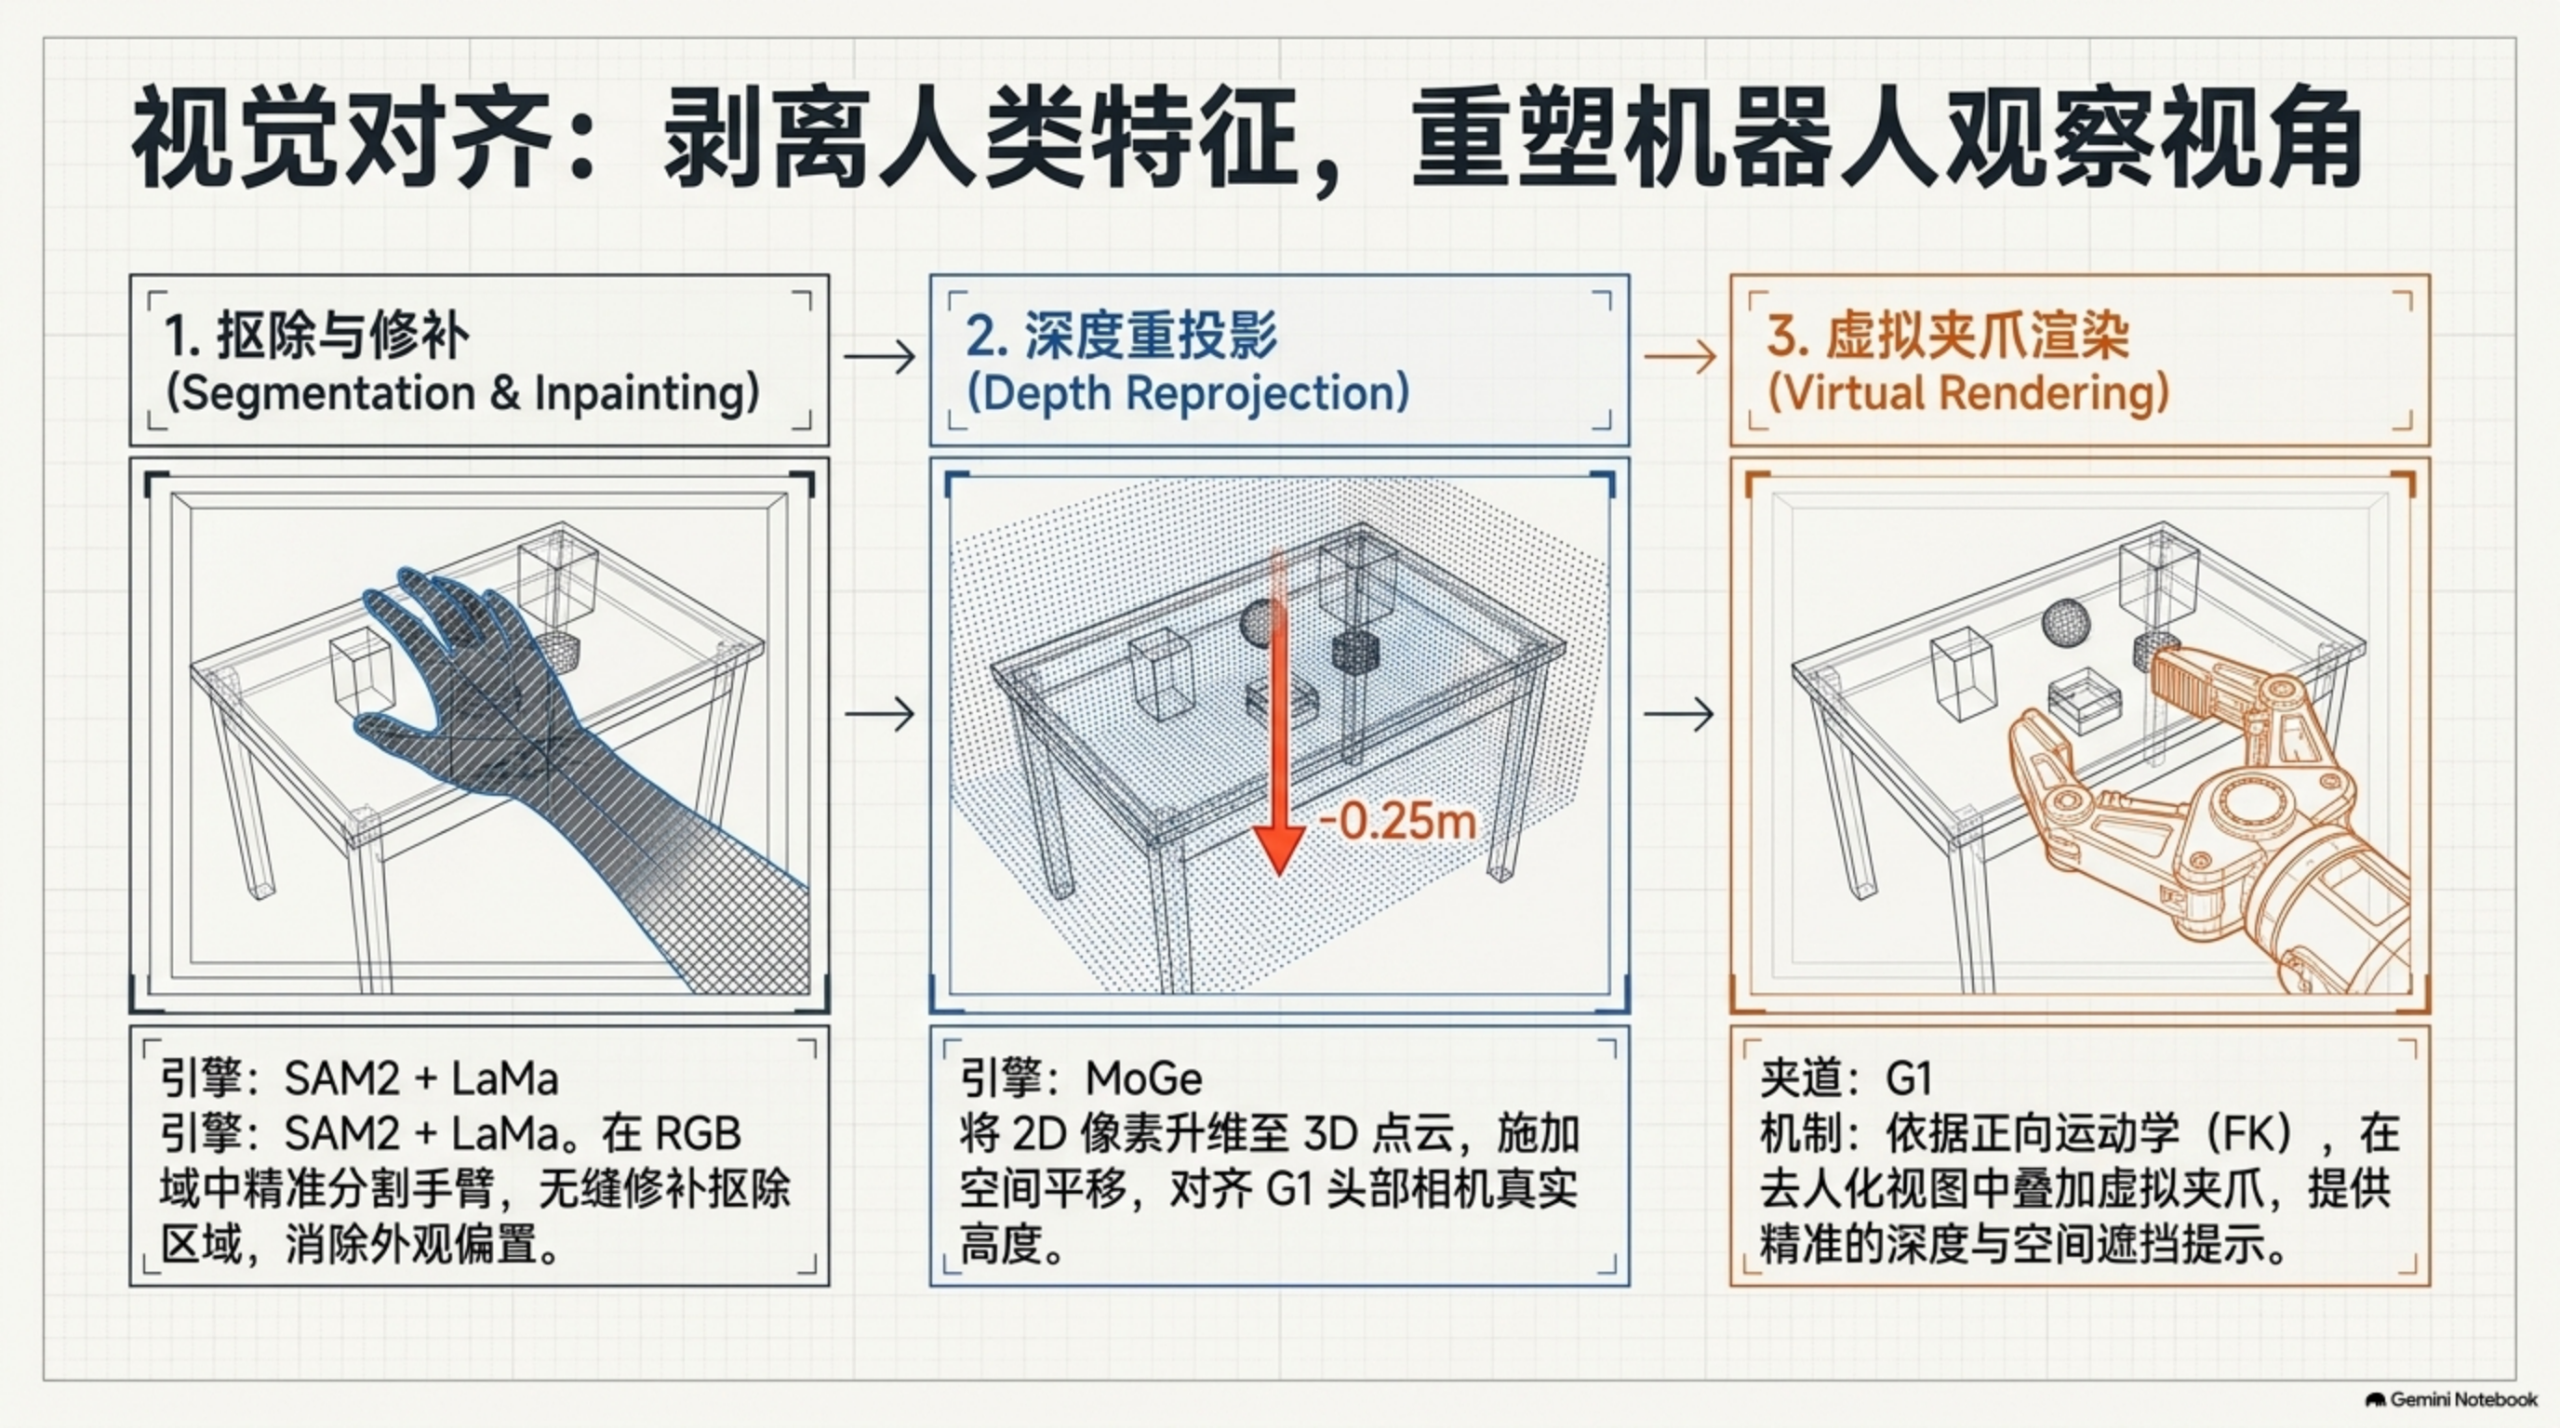
▲ 擦掉人手、重投深度、画上夹爪,生成机器人视角的伪演示视频
第二条路线更聪明:不改画面,改表示。EgoVerse 把人和机器人的动作统一投影到第一视角相机坐标系——人的手部轨迹在相机系下表示,机器人末端轨迹经正向运动学算出后也投影进同一个相机系。图像分布差得很远,动作分布却在同一个空间里。模型学的是"眼前这个位置,往下 5 厘米,合拢",跟执行者长什么样无关。
两条路线不冲突:前者服务需要像素级机器人视频的场景,比如世界模型训练;后者服务策略共训,成本便宜得多。
五、坐标系:整条管线的第一大坑
一帧手部数据诞生在相机坐标系,机器人活在基座坐标系,中间隔着一条完整的变换链。
标准链路四级:相机系经 VIO/SLAM 变换到世界系;机器人在世界系里有自己的基座锚点;最终把手部动作完整映射进机器人基座参考系。
T_base_hand = T_base_world · T_world_camera · T_camera_hand
任何一级外参标定错了,后面全错。跨设备时间戳没对齐,还会在快速动作上叠加一层空间错位。
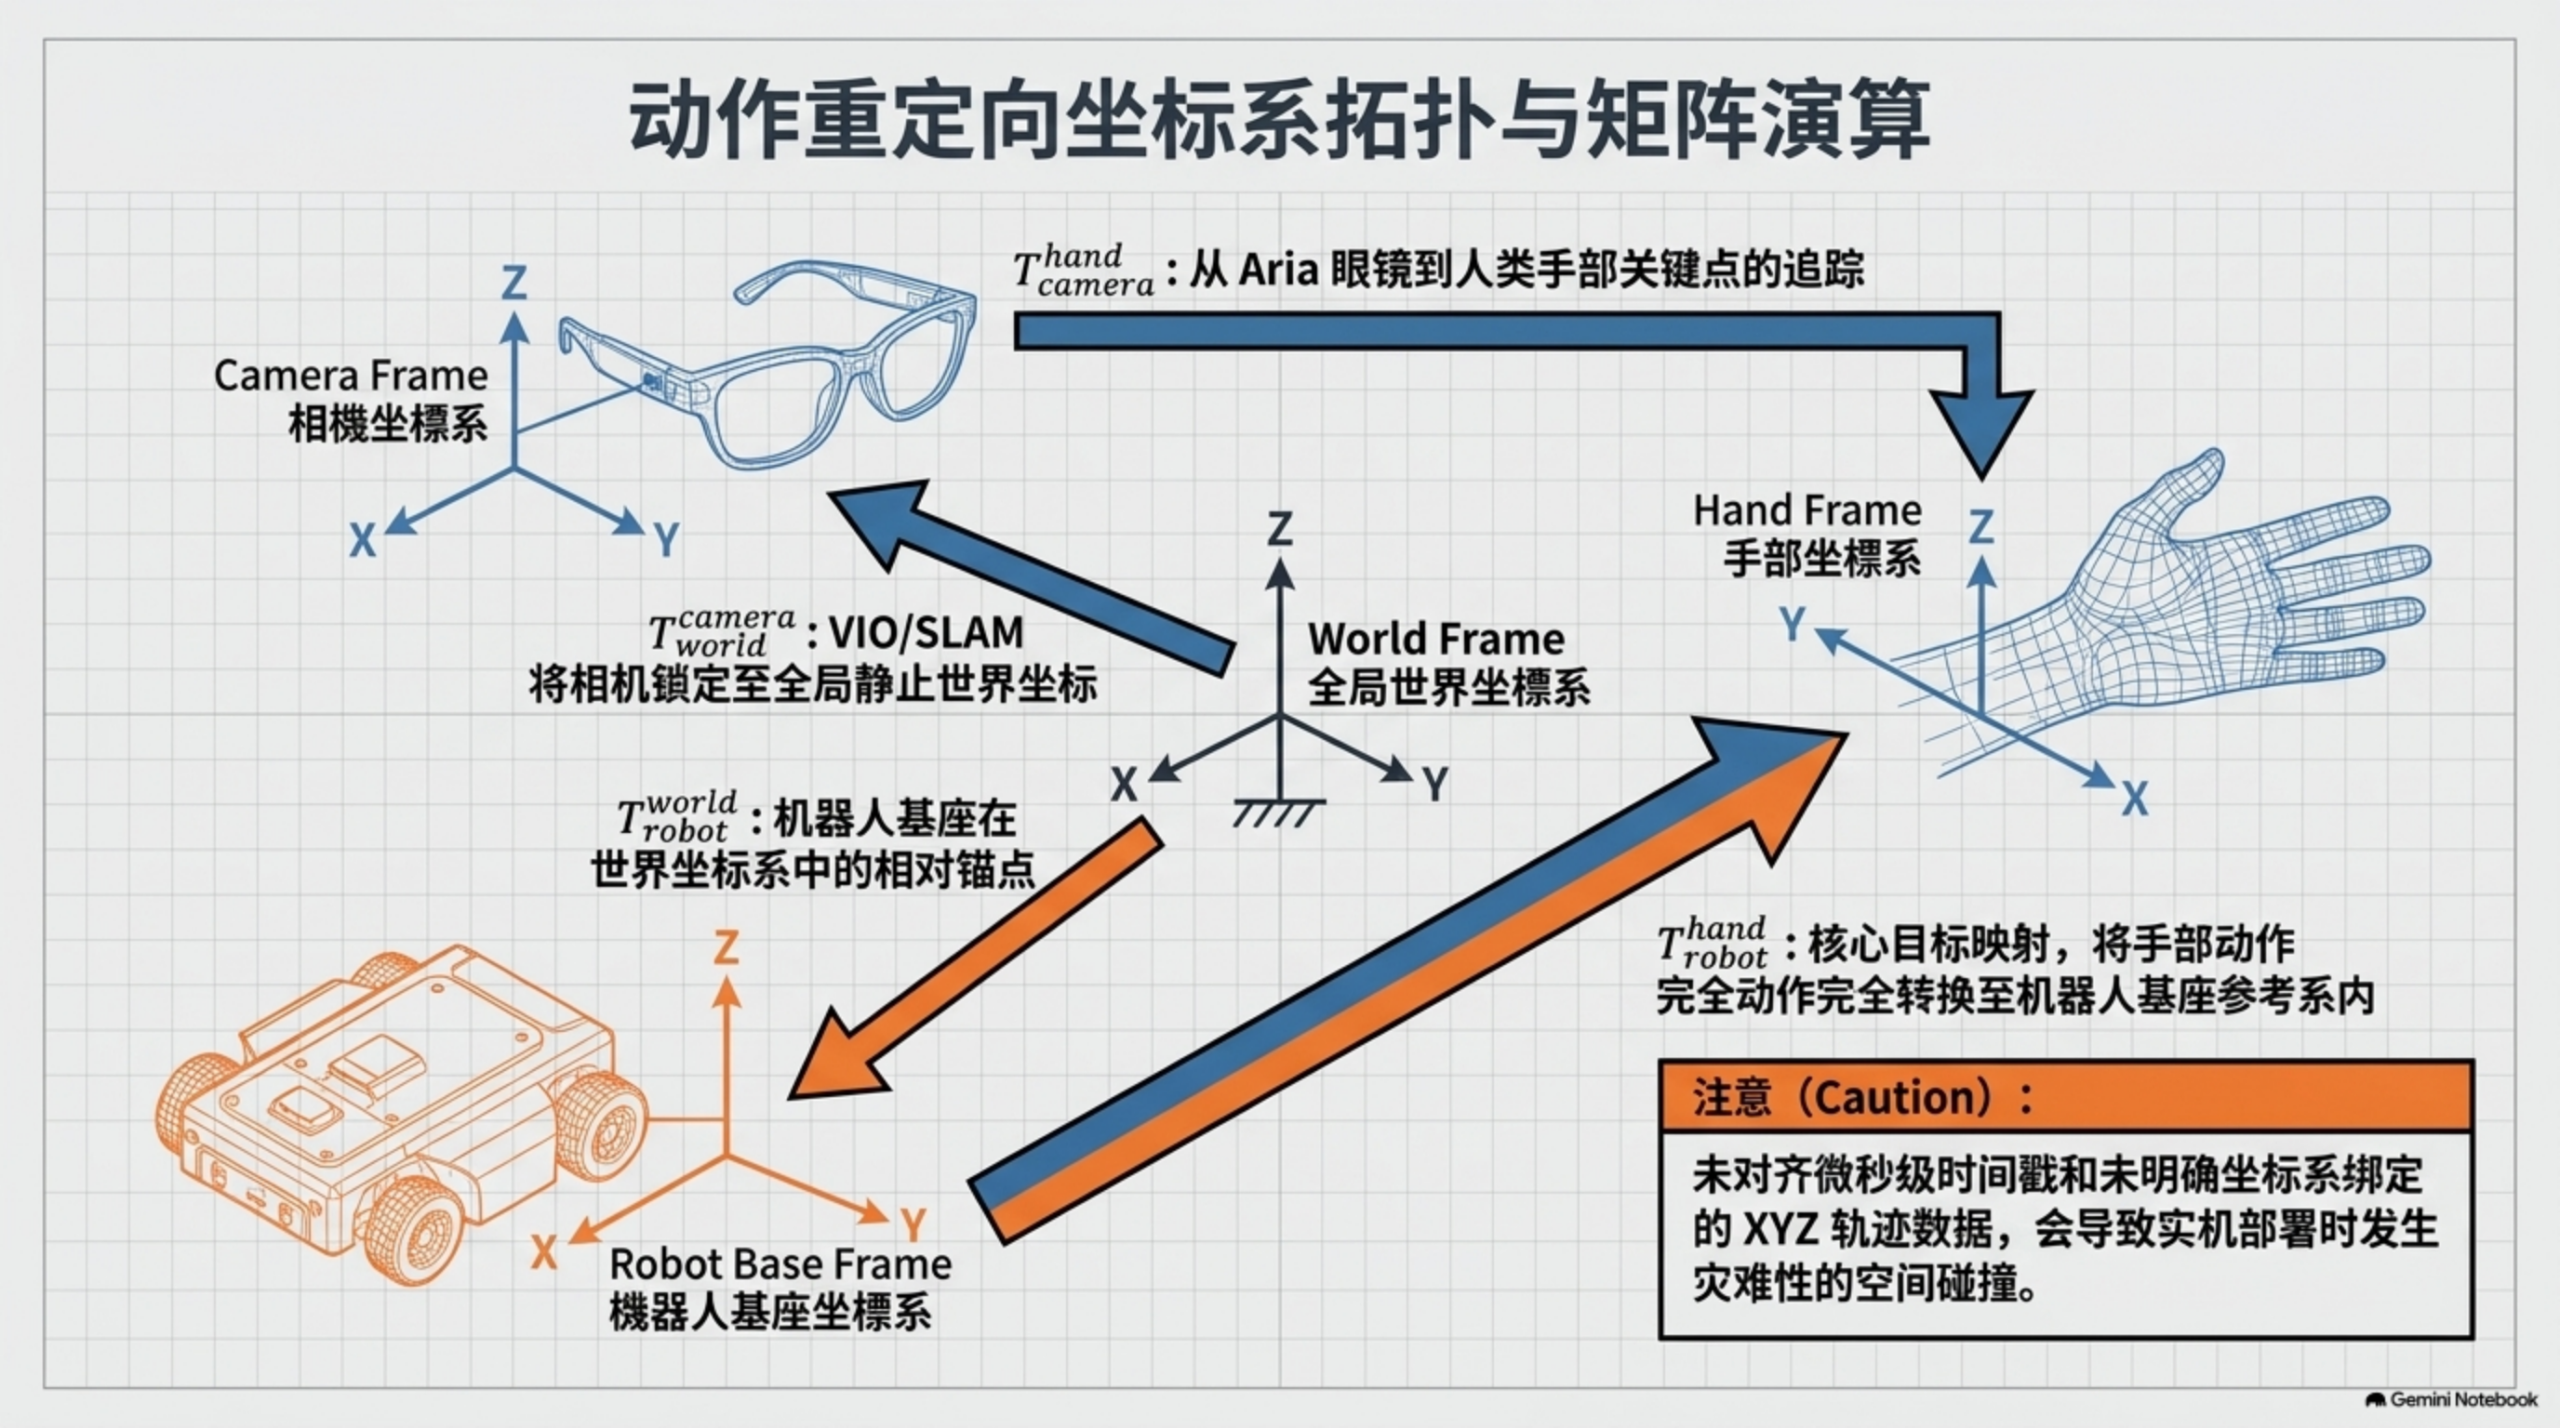
▲ 从眼镜到世界系到机器人基座,一条变换链贯穿两个本体
EgoVerse 的公式更干脆:把 t 时刻之后每一步的手部位姿,左乘当前相机位姿的逆,得到一个纯相对量——手相对于此刻头部的位移序列。机器人侧对称处理:关节角经 FK 到基座系,再投影回 ego 相机系。两边都成了相机系下的相对轨迹,坐标系差异被一次性消掉。
工程铁律只有一条:所有关键点必须标明归属——World、Camera 还是 Robot Base,杜绝游离坐标。只存 xyz 不说 frame 的数据,约等于废数据。
六、臂、手、腿:三个部位三套映射法
臂部用 6 自由度相对末端位姿变化量。绝对坐标易受光照和建图误差干扰,解法是把腕部绝对坐标转成相对动作块起始点的增量,彻底摆脱全局坐标系依赖,换来跨场景泛化。
手部是高维骨架到低维实爪的降维。25 自由度仿真手没法直接驱动 3 自由度夹爪,解法是提取 26 个指节关键点计算曲率,经阈值操作二值化成一维开合指令。听起来信息损失巨大,但夹爪本来就只有开合两个状态,剩下的自由度本来就是冗余。
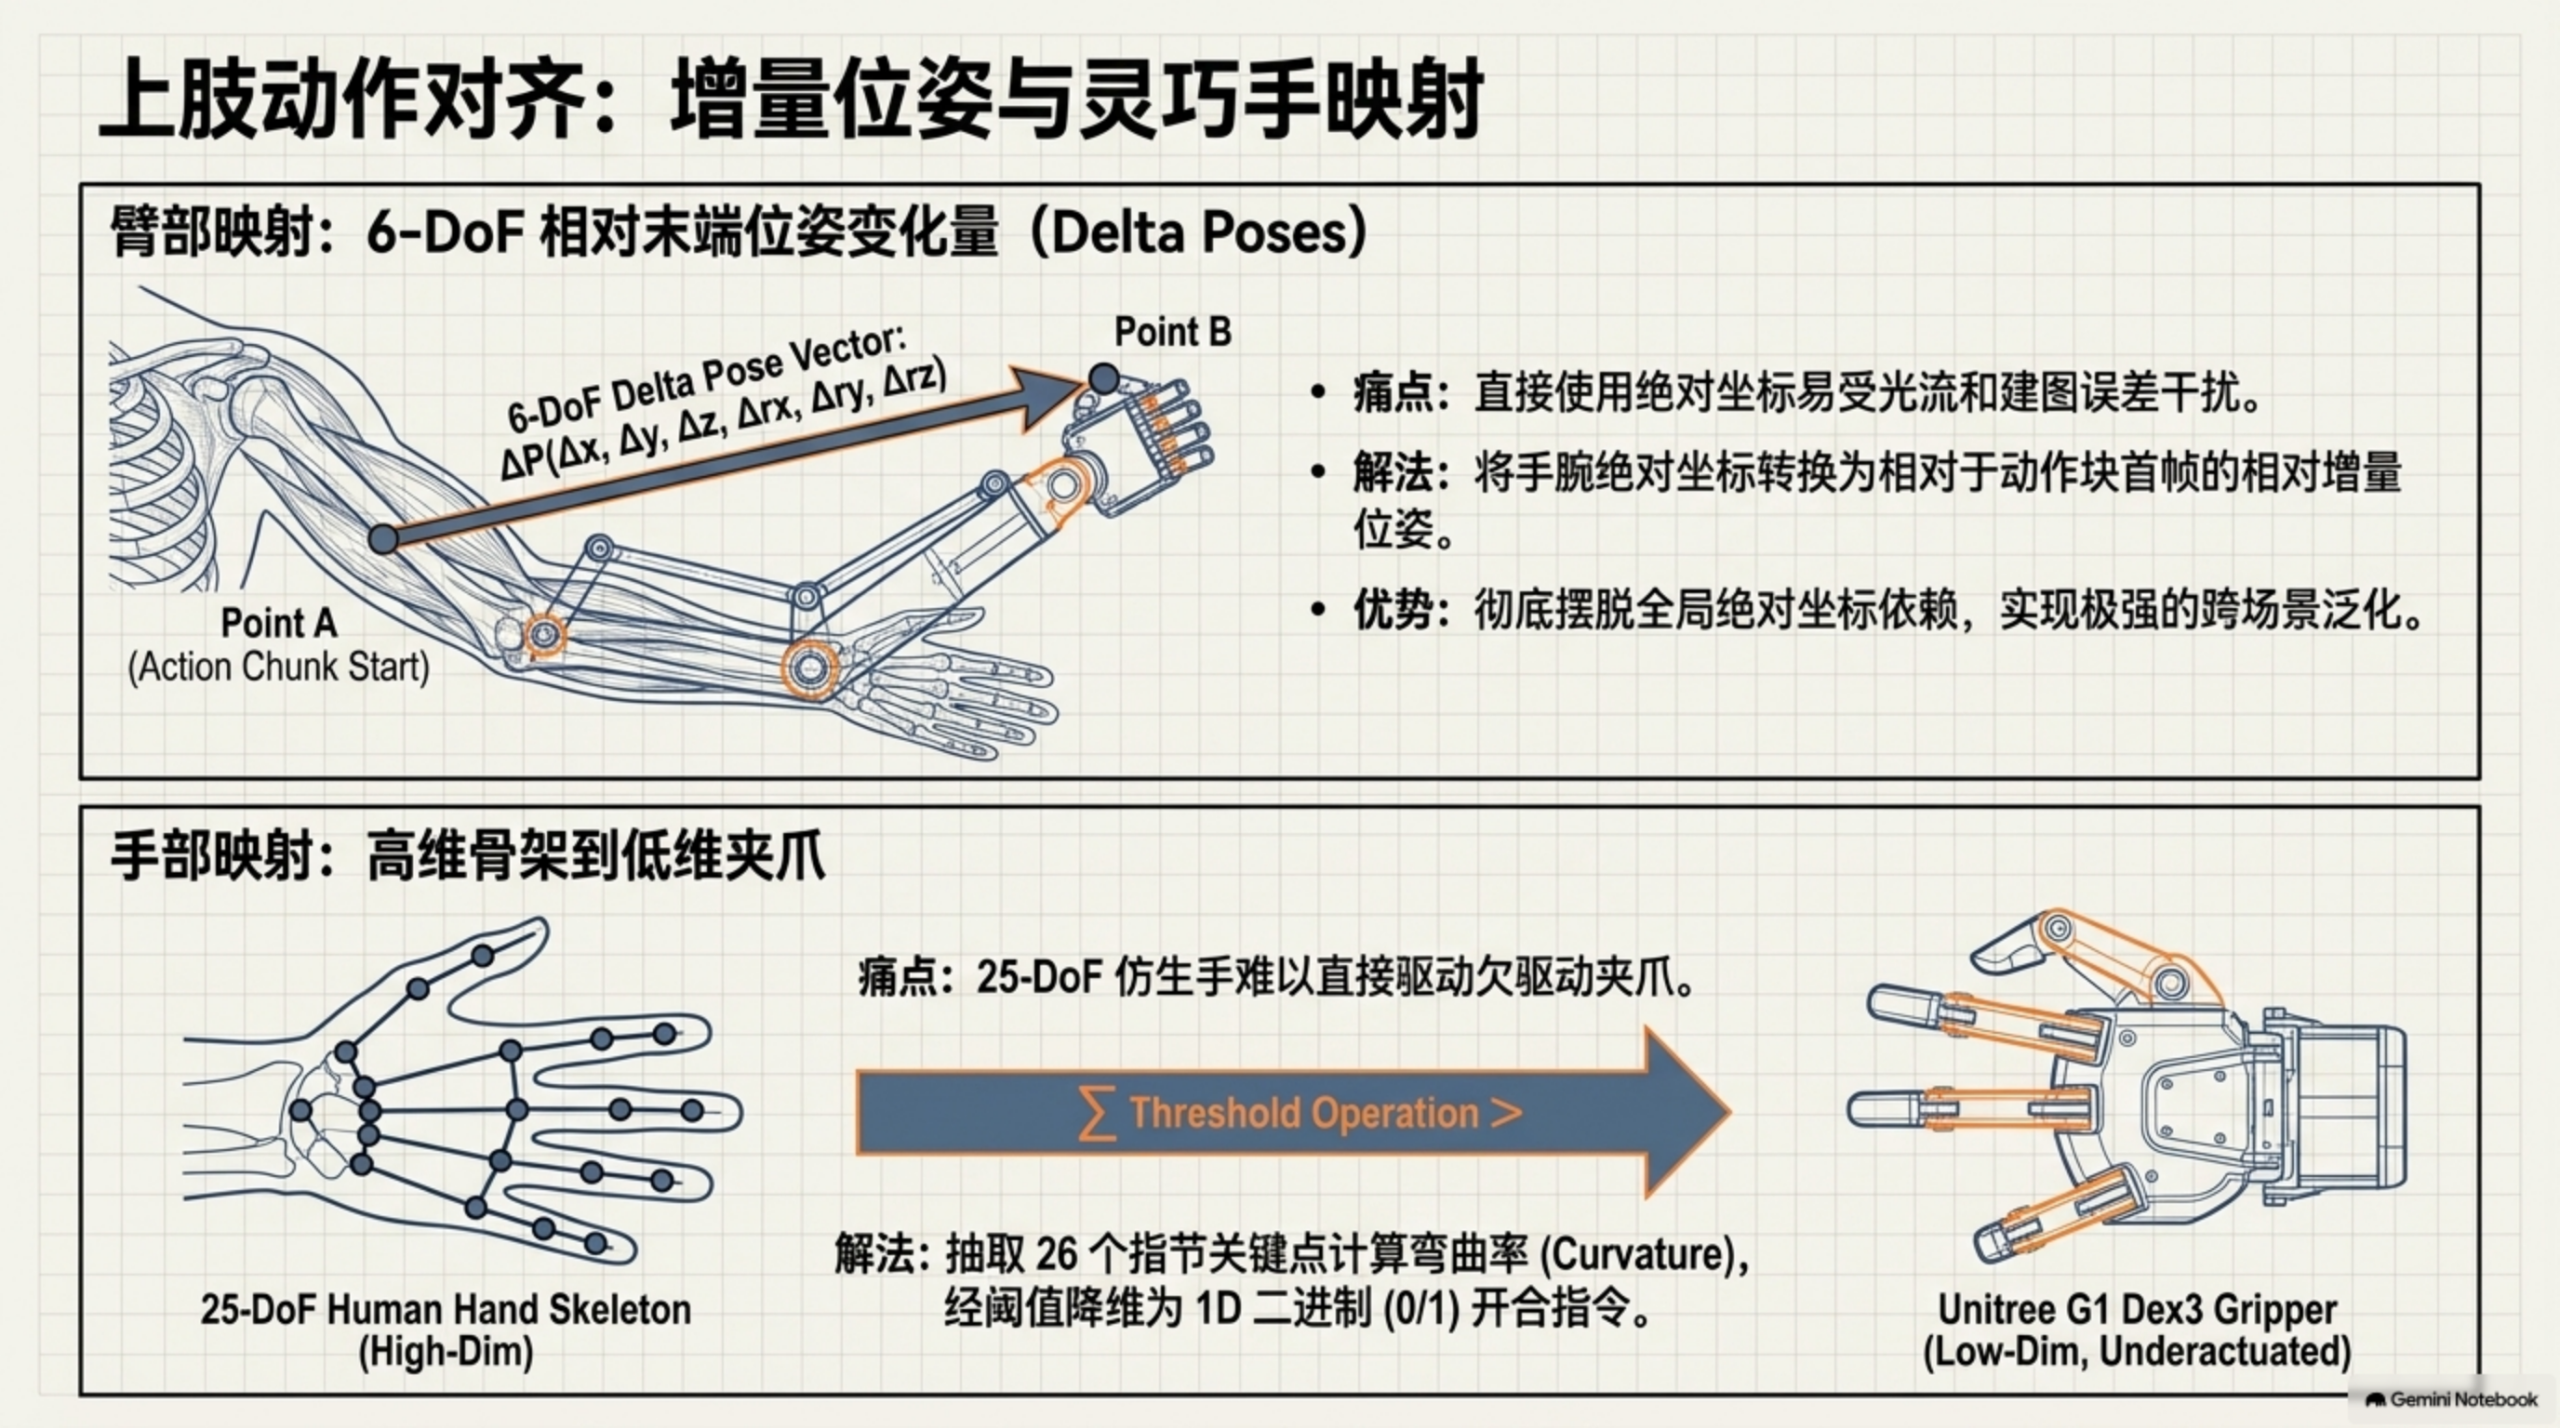
▲ 臂部走增量位姿,手部走曲率二值化,各降各的维
下肢从骨盆轨迹到离散步态。提取骨盆运动轨迹,Savitzky-Golay 滤波器抑制高频抖动,算出瞬时航向;3D 位置按侧移量量化成前进后退、左右平移、偏航转向的离散指令;Z 轴高度变化映射成一维蹲立指令。人只管正常走路,机器人拿到的就是几个离散的步态 token。
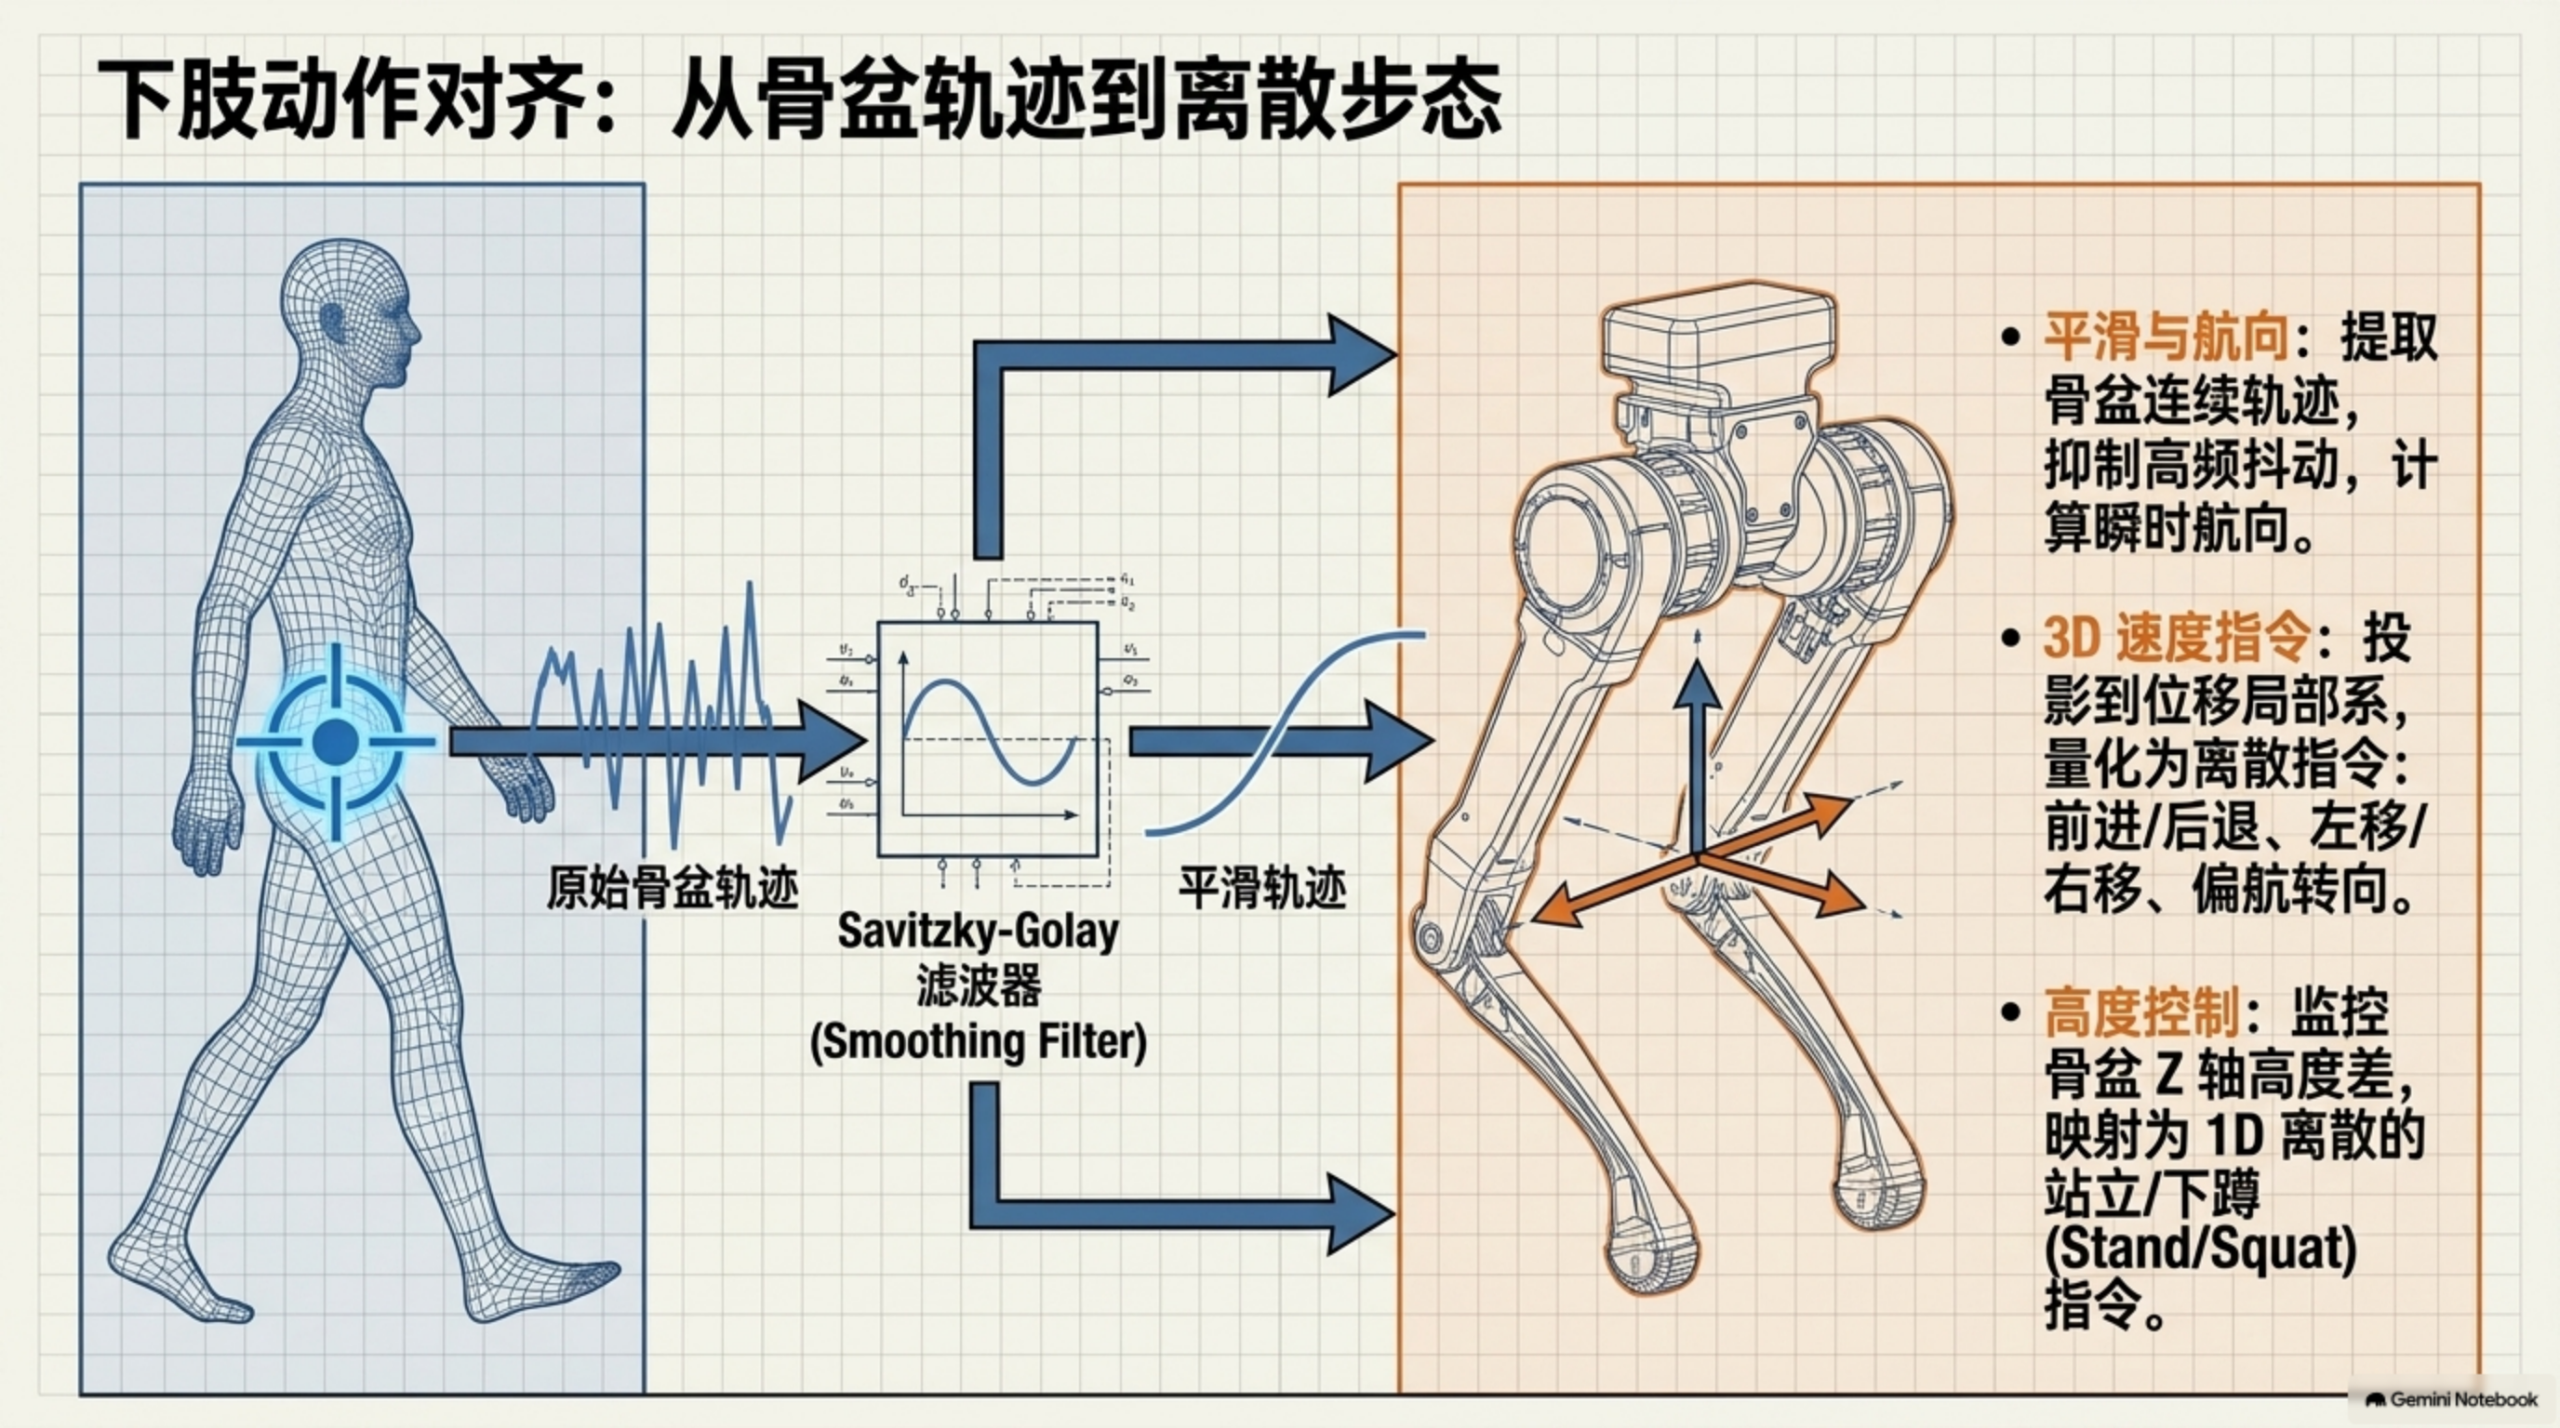
▲ 平滑、量化、离散化,人的步态变成机器人的三个指令通道
灵巧手是另一条路。EgoVerse 的 G1 平台装了六自由度 Inspire 灵巧手,人手 21 个关键点里的五个指尖位置,经逆运动学直接解算成关节指令。规律很明显:末端执行器越接近人手,重定向损失越小。反过来也成立——夹爪越简单,越要靠任务语义补齐丢失的信息。
七、三个工程暗坑,每一个都能让管线白建
暗坑一:旋转奇点。人类数据的三维旋转噪声极大,直接映射会导致机械臂抖动、陷入奇异点甚至自碰撞。解法是 Bridging Action:预训练阶段主动剥离旋转分量,仅依靠三维平移作为核心锚点构建运动表征;微调阶段用少量真实机器人数据,在固定平移框架下再补齐 6 自由度姿态,彻底阻断累积误差引发的指令发散。
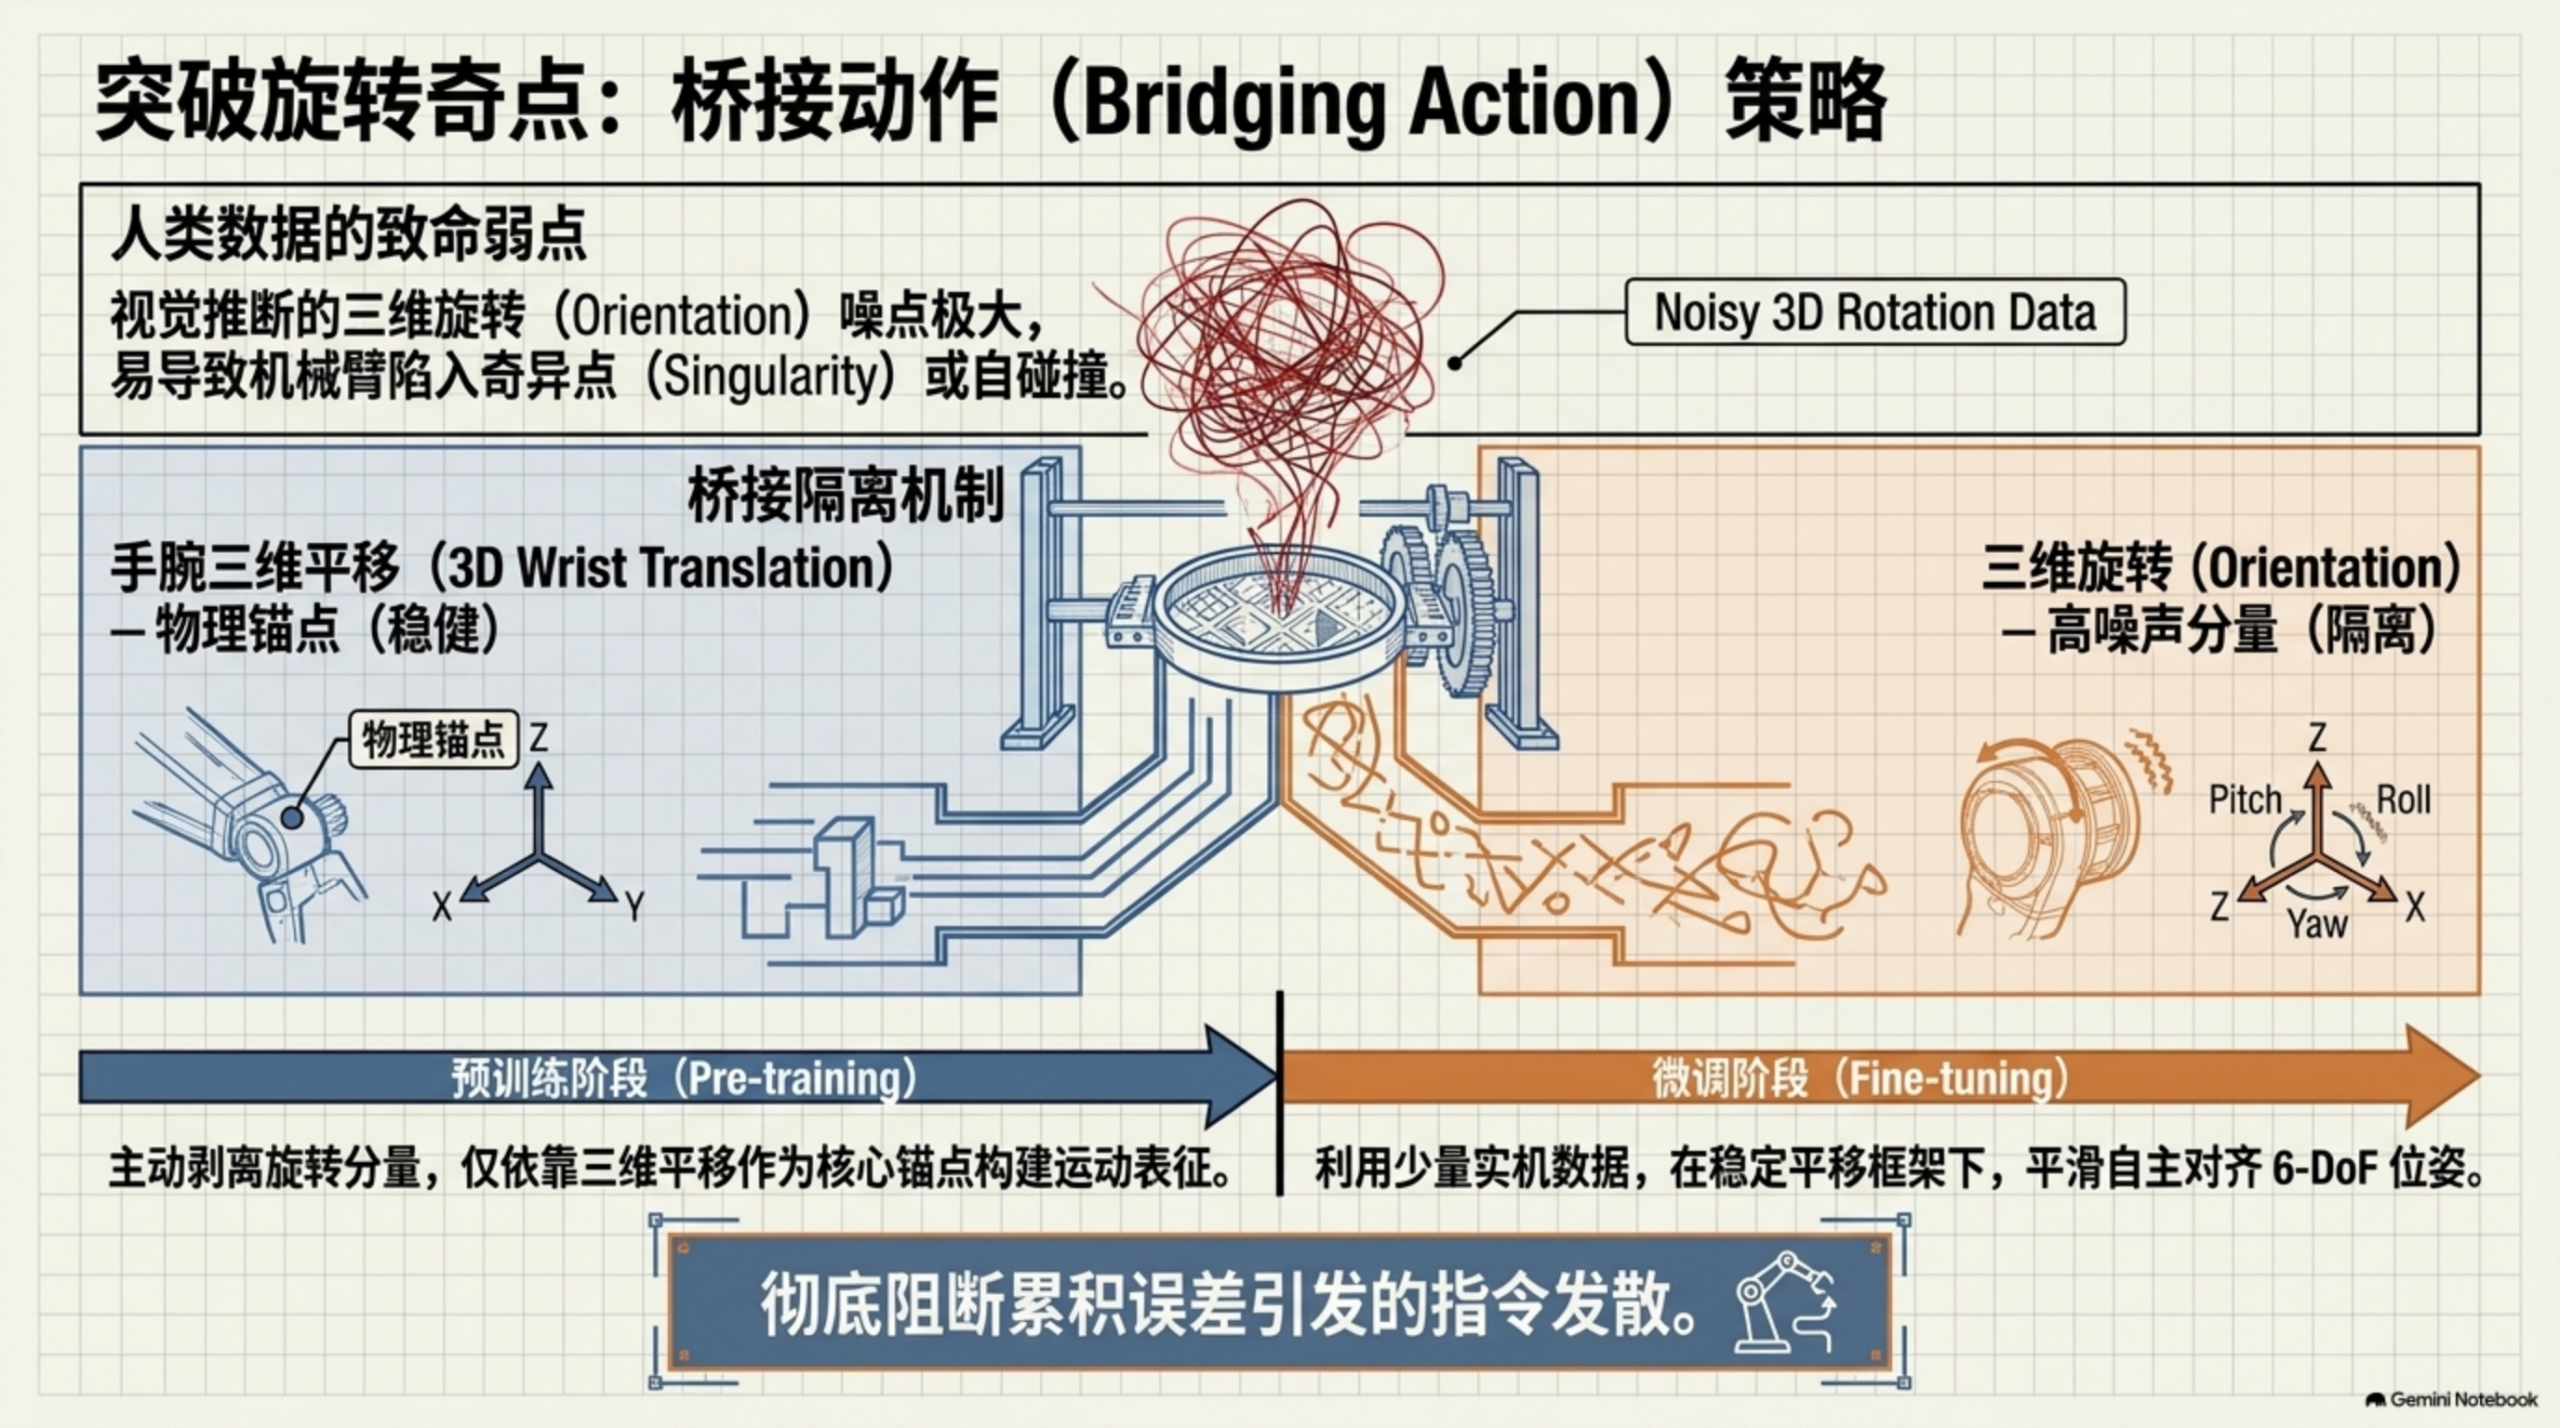
▲ 平移做锚、旋转隔离,预训练和微调各取所需
暗坑二:时间对齐。人干活快,机器人执行慢。EgoVerse 的处理:人取 1 秒动作窗口,机器人取 1.5 秒,统一重采样到 100 步;位置做线性插值,旋转做球面插值 SLERP。本体感觉和动作再做分位数归一化,把 1% 和 99% 分位拉到 [-1,1],防止极端值污染训练。节奏差异被时间缩放吸收掉,两种本体的动作才进得了同一个 batch。
暗坑三最隐蔽:策略错配。EgoVerse 的 Robot B 在装袋任务上共训后性能不升反降,是全部实验里唯一的反例。复盘发现:人和 Robot A 开购物袋都是双手撑开、往里放;Robot B 因为侧装肩架的结构限制,遥操作时演化出另一套策略——一只夹爪撑住袋口,另一只往里塞。同一个任务名,两种执行分布,共训时互相打架。
这个案例的价值在于点破一件事:数据对齐不只是数值对齐,还有策略对齐。如果本体结构迫使机器人用和人不同的方式干活,这批机器人数据混进去不但没用,还有毒。
八、物理回放:天真回放必死,要靠阻抗控制
为什么不直接把坐标转换结果发给机器人?
天真回放是直接位置 PID 强控。微小的角度误差会让机械臂磕碰物理环境,瞬间产生刚性碰撞。回放不等于复现:数学上完全一样的轨迹,真机上照样砸桌——因为人的动力学和机器人的动力学不同,速度限制、加速度限制、奇异点、控制频率、接触力、延迟,全都不一样。
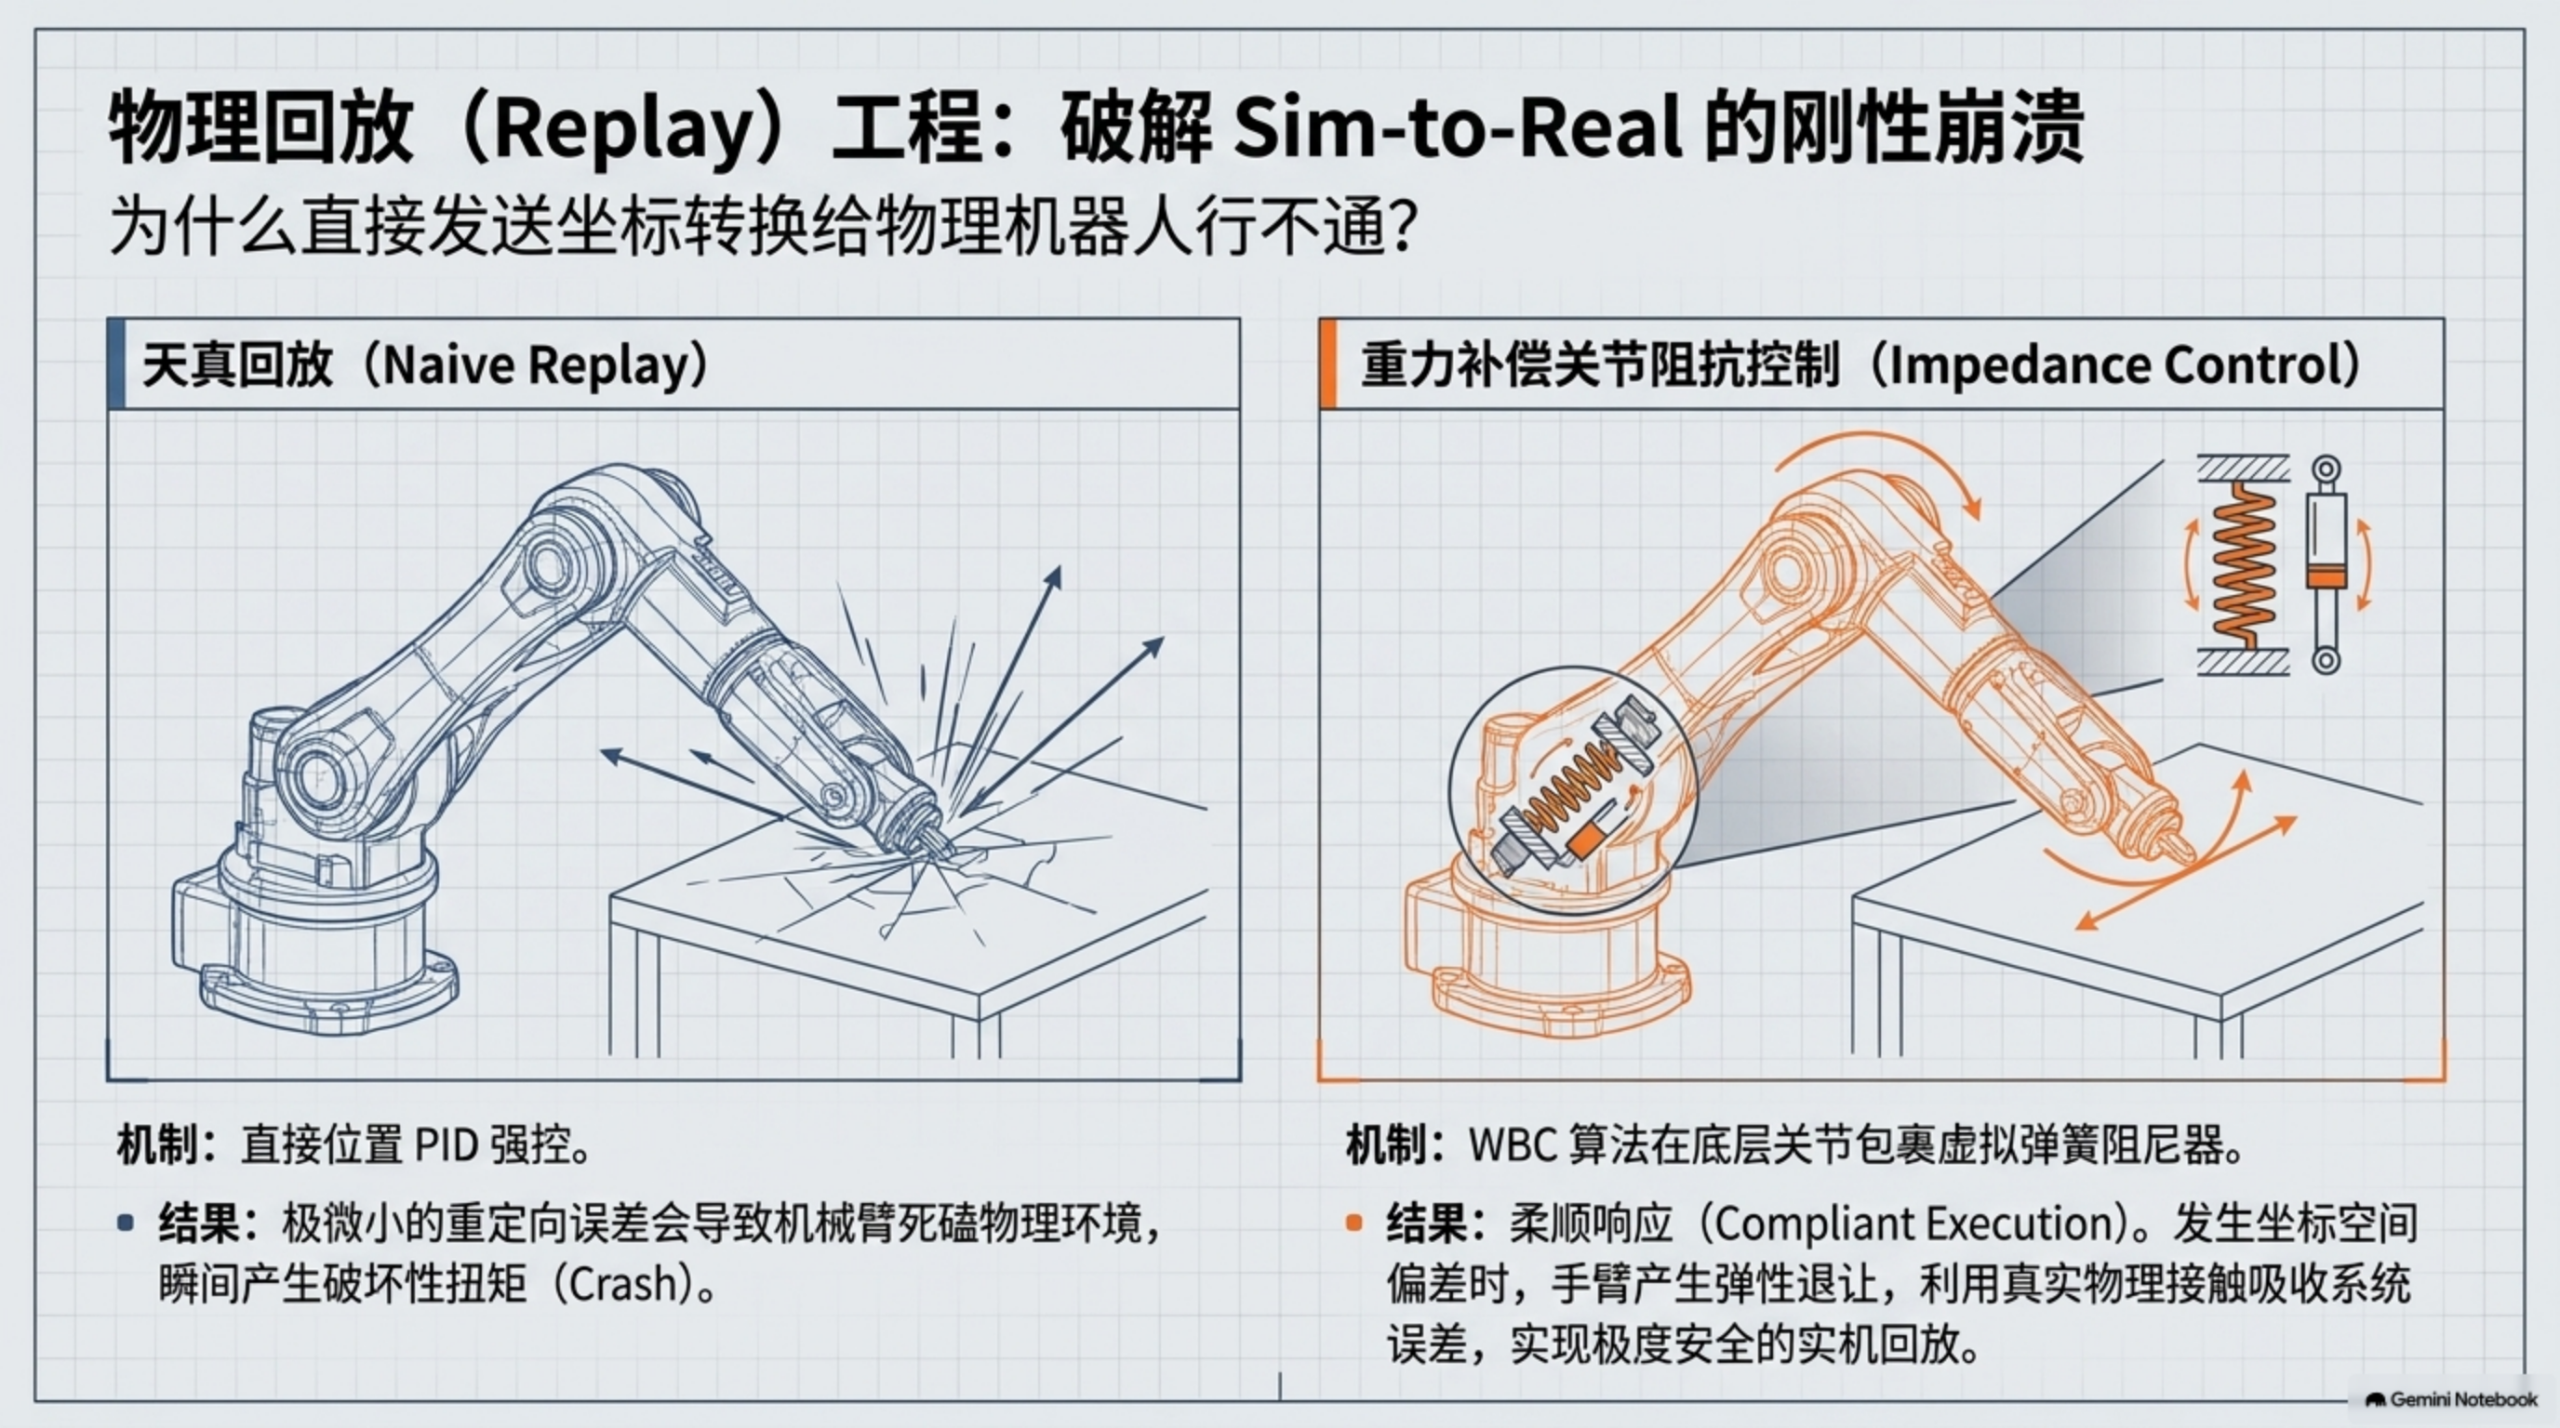
▲ 同一条轨迹,PID 硬控撞桌,阻抗控制柔顺吸收误差
正确姿势是重力补偿加关节阻抗控制。WBC 全身控制算法在底层关节包一层虚拟弹簧阻尼器,手臂产生轻微形变,用真实的物理接触吸收误差,实现高度安全的实机回放。
完整链路是:GPU 主机运行 VLA 大模型,接收 20Hz 多模态输入(视频、本体状态、语音指令),经 WebSocket 下发 18 维动作块——12 维双臂相对位姿、3 维移动速度、1 维蹲立、2 维左右夹爪开合——机载计算机接收后做逆运动学与全身动力学计算,下发执行。
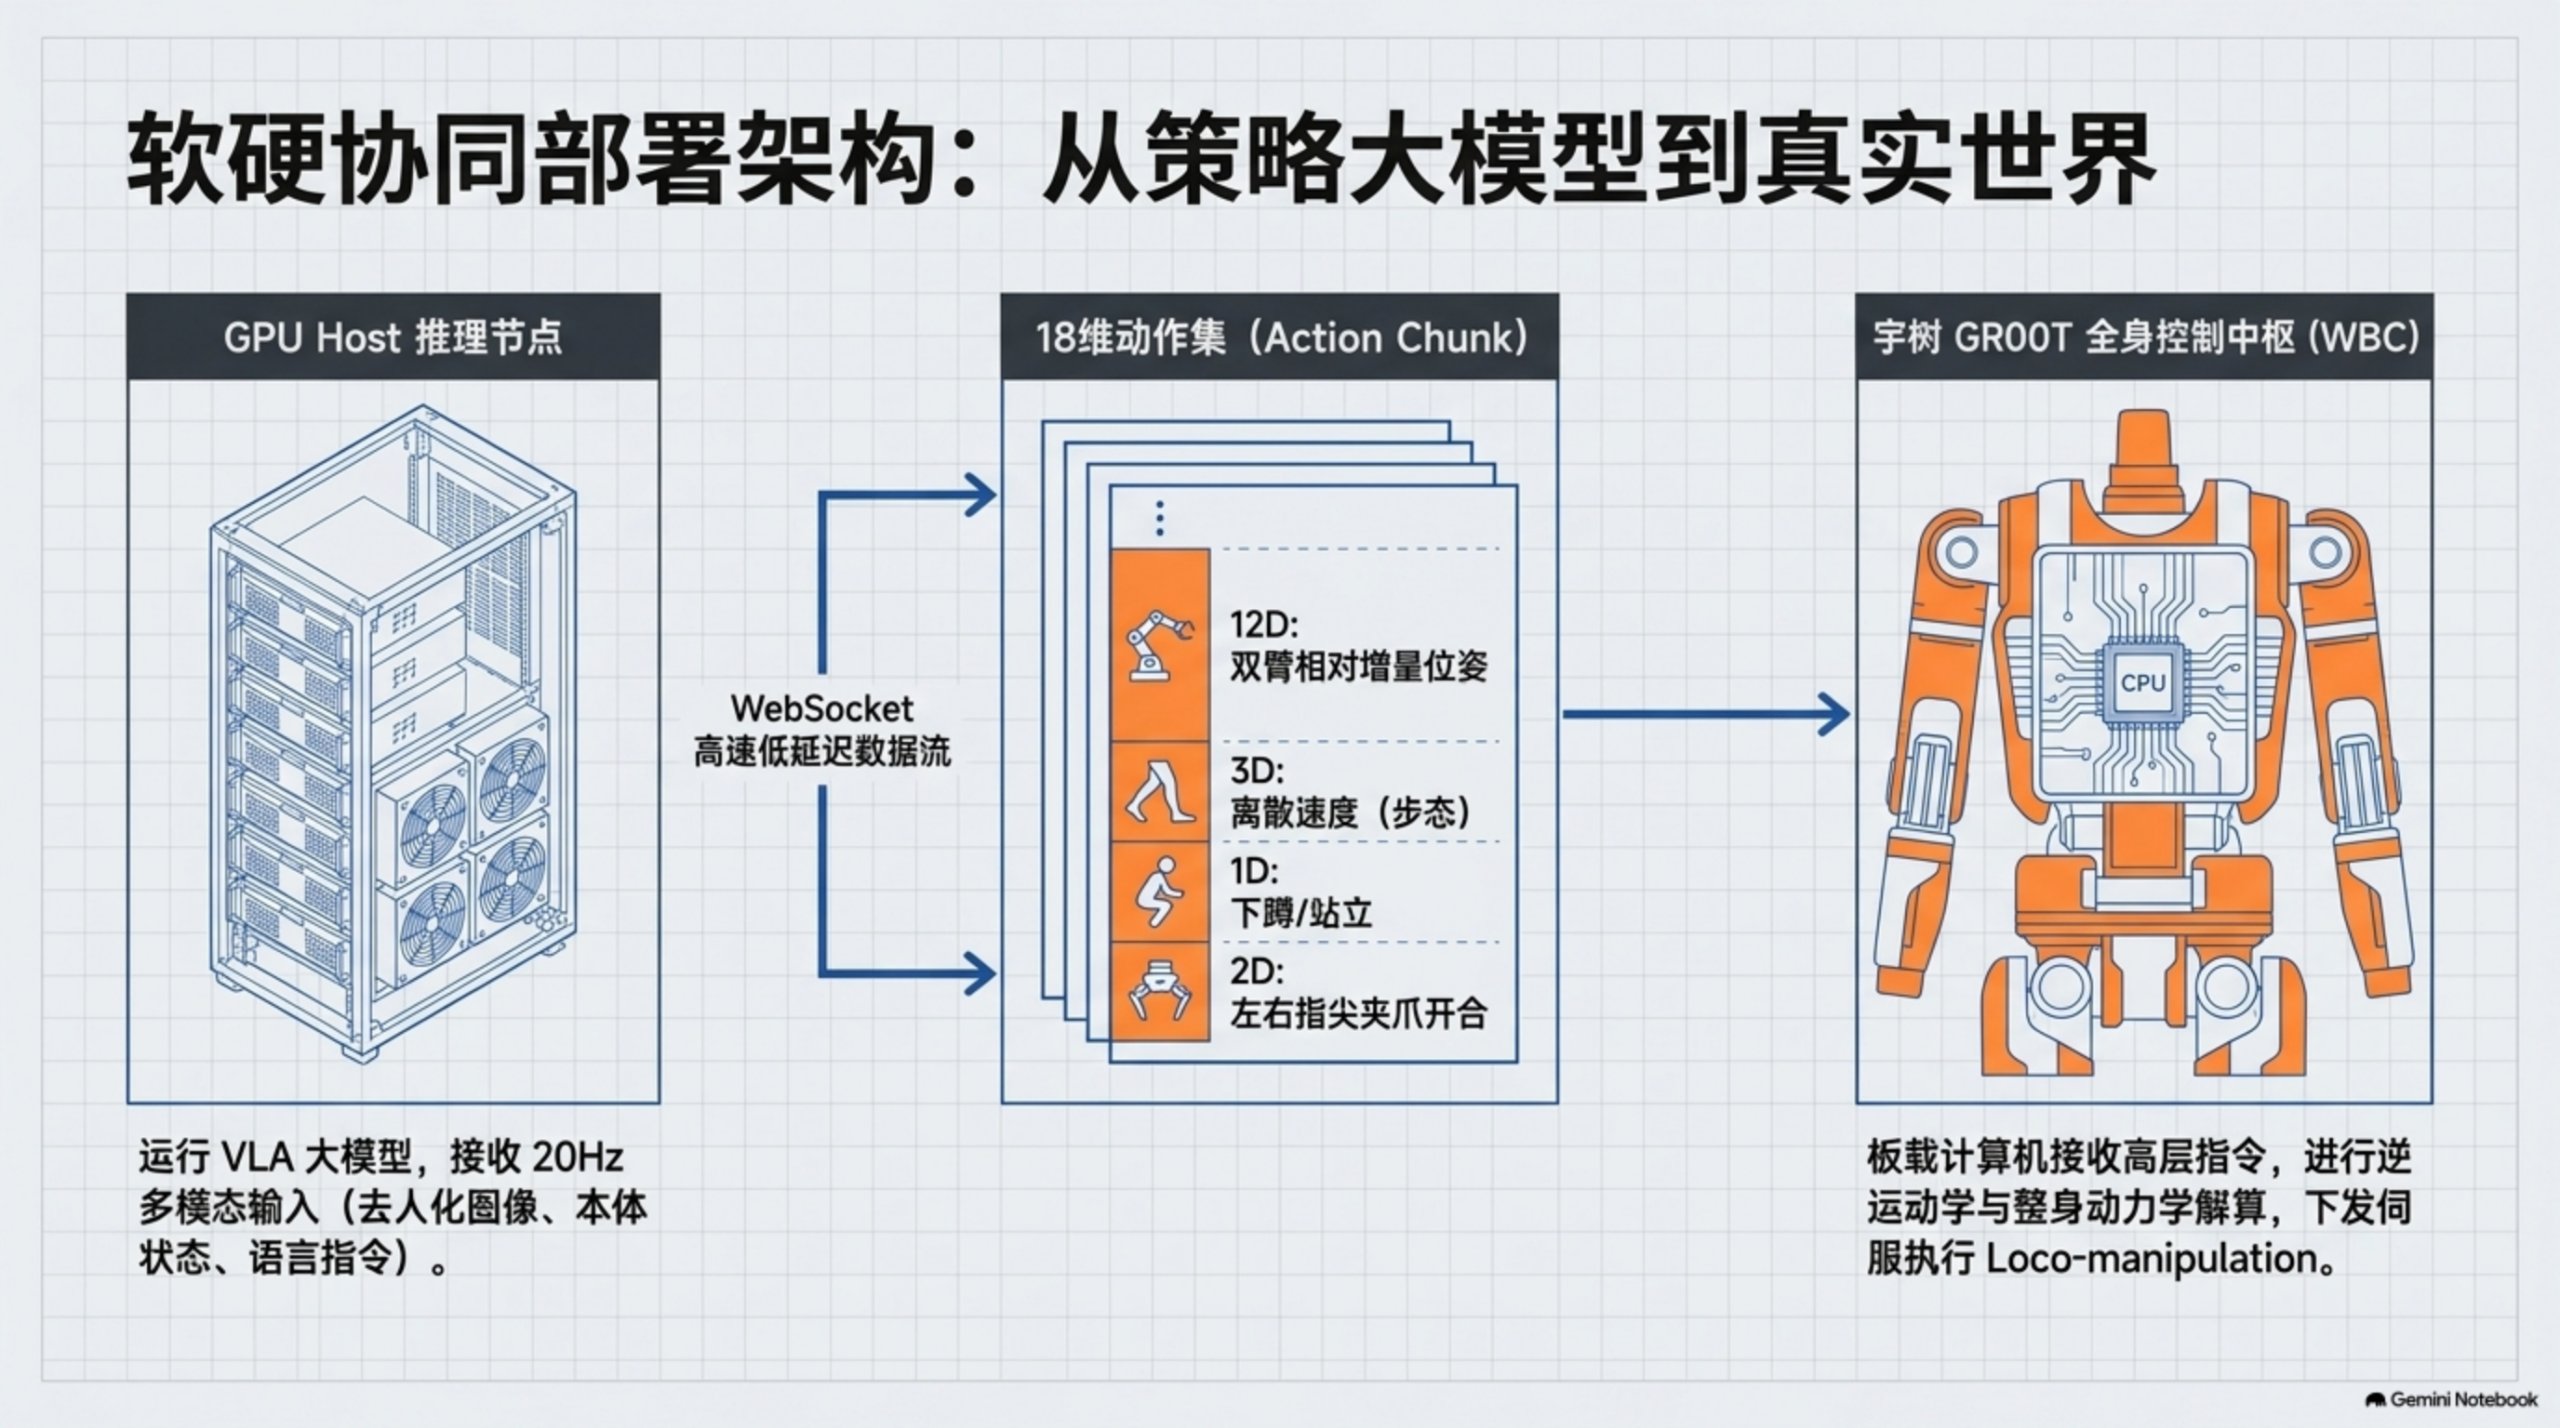
▲ 策略大模型、动作块、全身控制器,三层各管一段
回放前先在仿真里过一遍:Isaac 或 MuJoCo 里验证轨迹无碰撞、关节不超限,再上真机。这也是无本体数据资产的验收场。
九、打通之后,同一份数据有三种归宿
第一,回放验收。检验 Retargeting 管线的正确性,代价最小,每批数据都该过。
第二,策略共训。Ego 数据提供极致的场景多样性与自然交互意图,少量遥操作数据提供真实的电机扭矩、相位反馈与高精度物理接触锚点,混训出一个统一策略大模型。
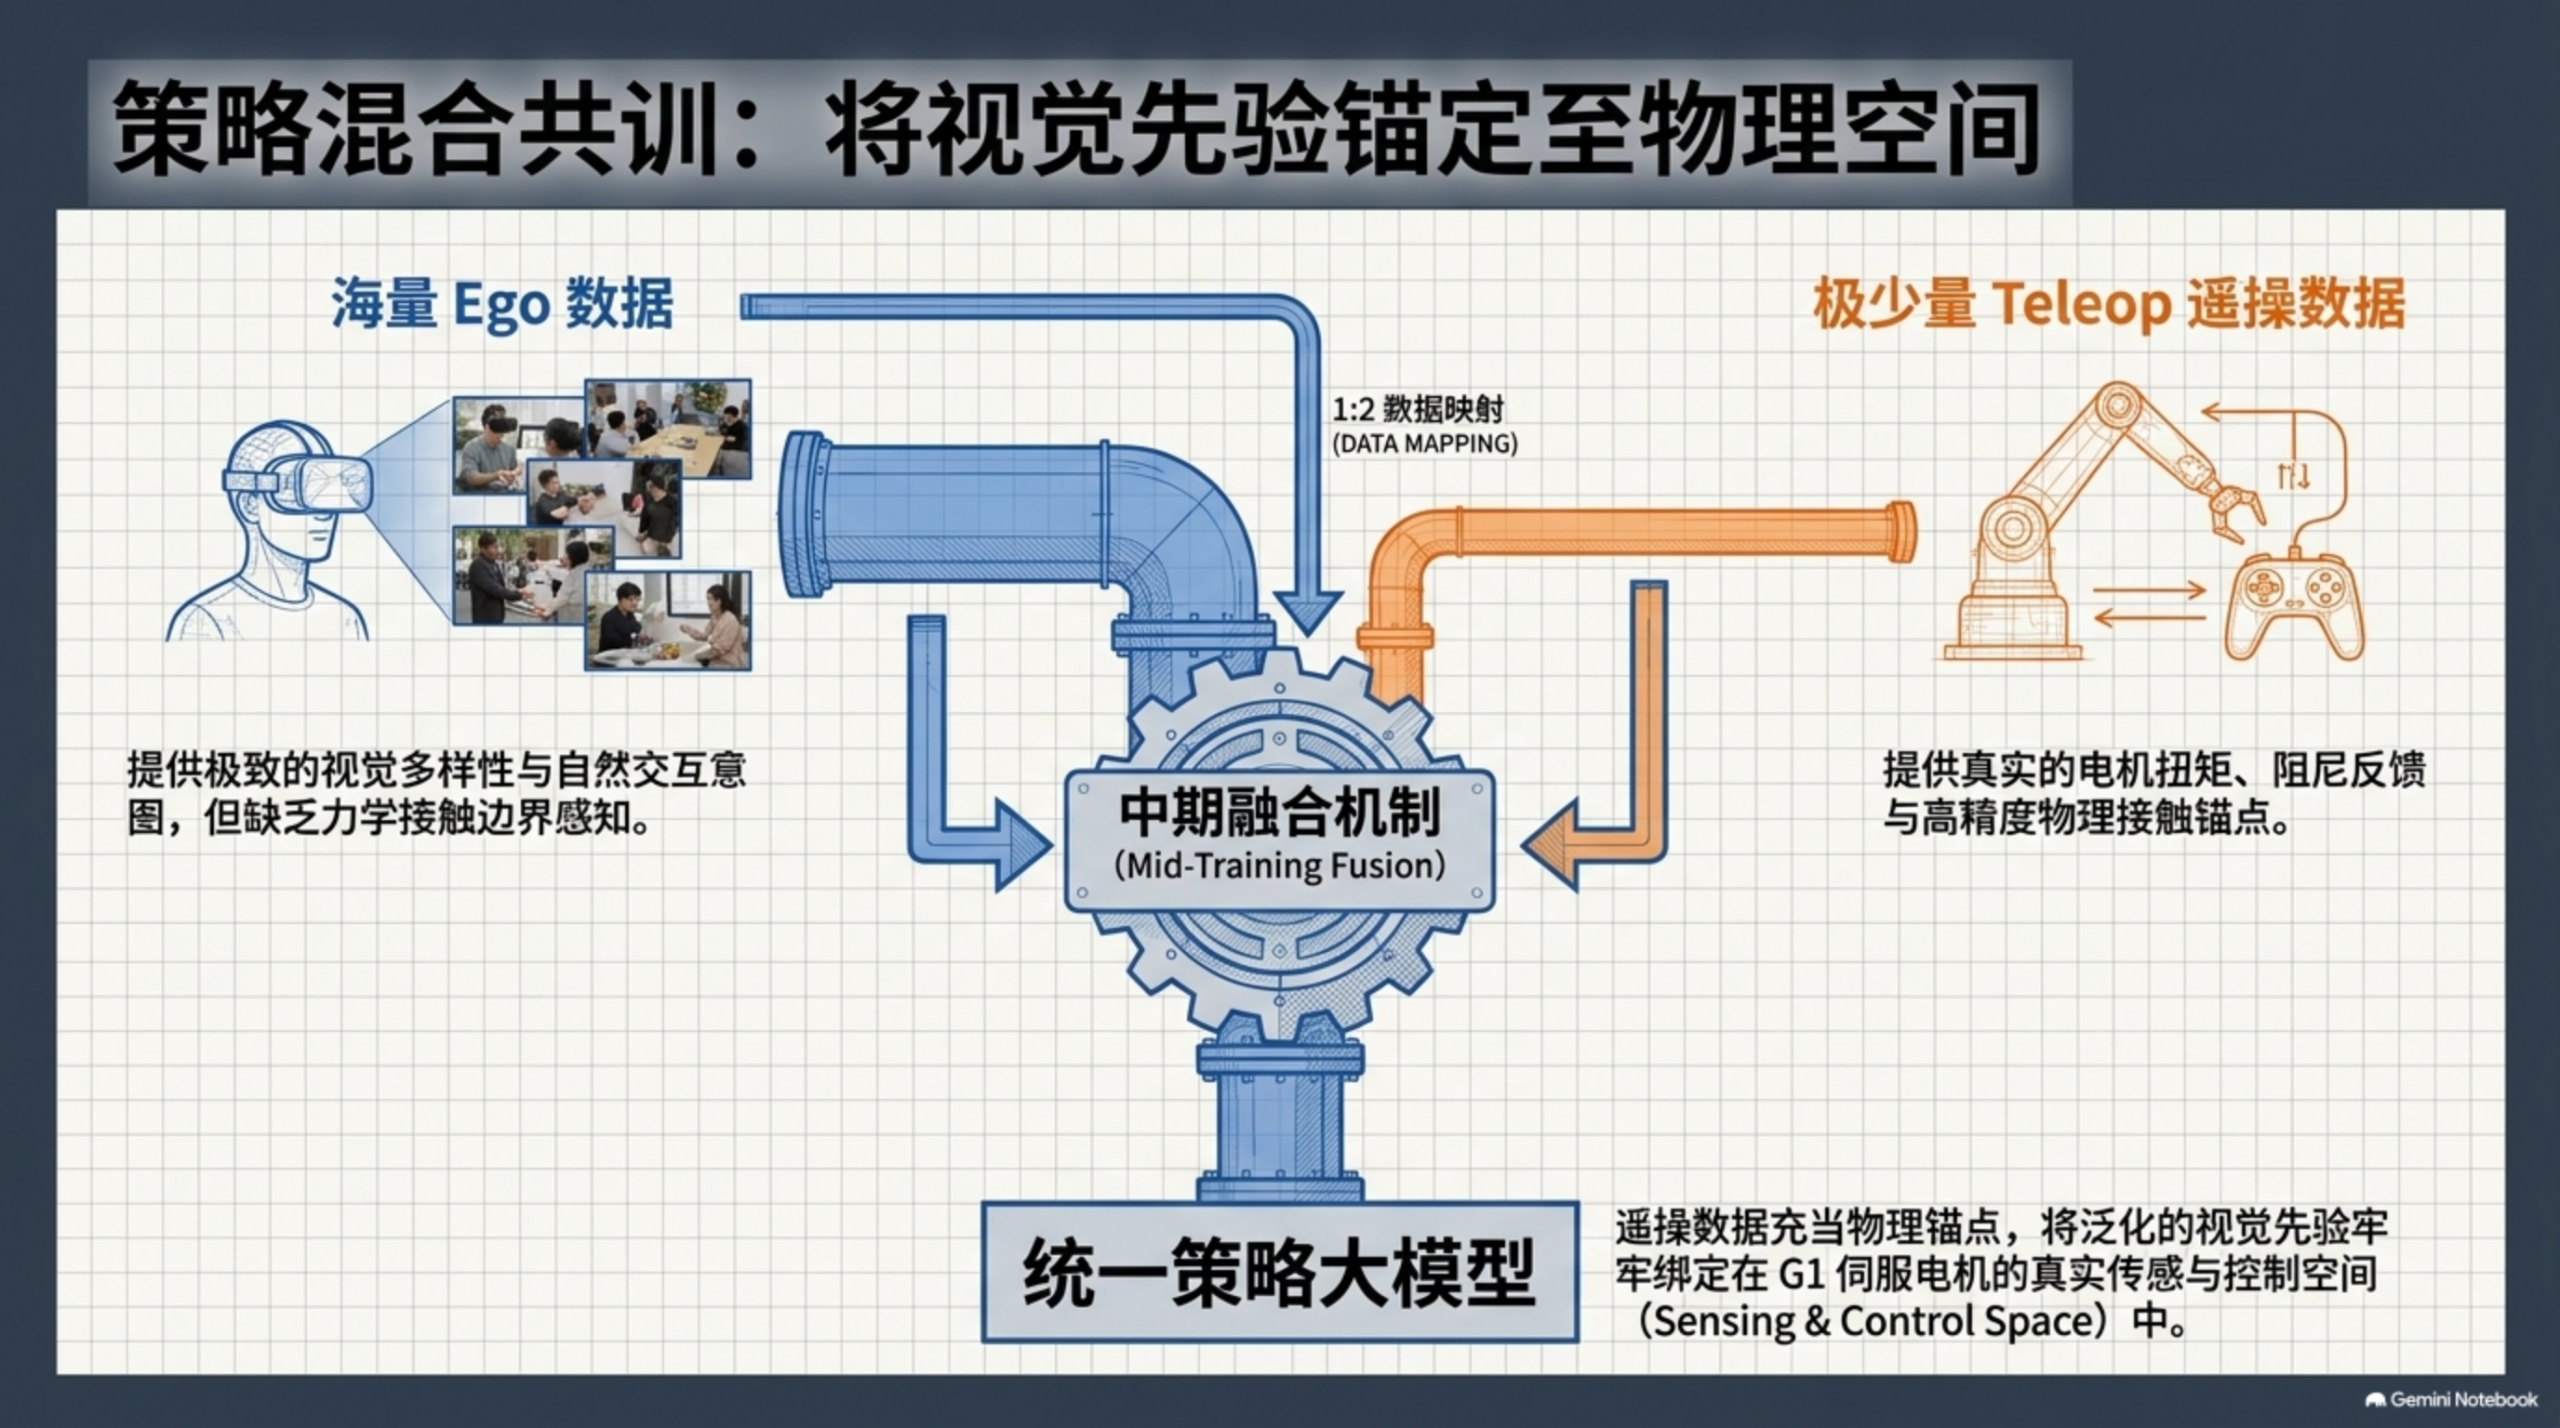
▲ 海量 Ego 数据提供广度,少量遥操数据提供锚点
第三,世界模型与 VLA 预训练。让模型先在人类视频里看懂物理世界,再用少量机器人数据微调动作空间。
EgoVerse 给出了共训路线目前最扎实的数字:人机数据共训让分布内和分布外性能最高提升 30%。但 scaling 有个前提——必须有对齐数据做锚:哪怕只有 2 小时与机器人任务同场景、同物体的人采数据,8 小时多样化 Ego 数据的增益才能被激活;没有锚点,8 小时数据单独喂进去,几乎白喂。
十、Robot-Ready 验收清单:五条硬指标
要让 Ego 视频成为能直接进仿真和 VLA 训练的实机资产,得跨过五条硬性指标。
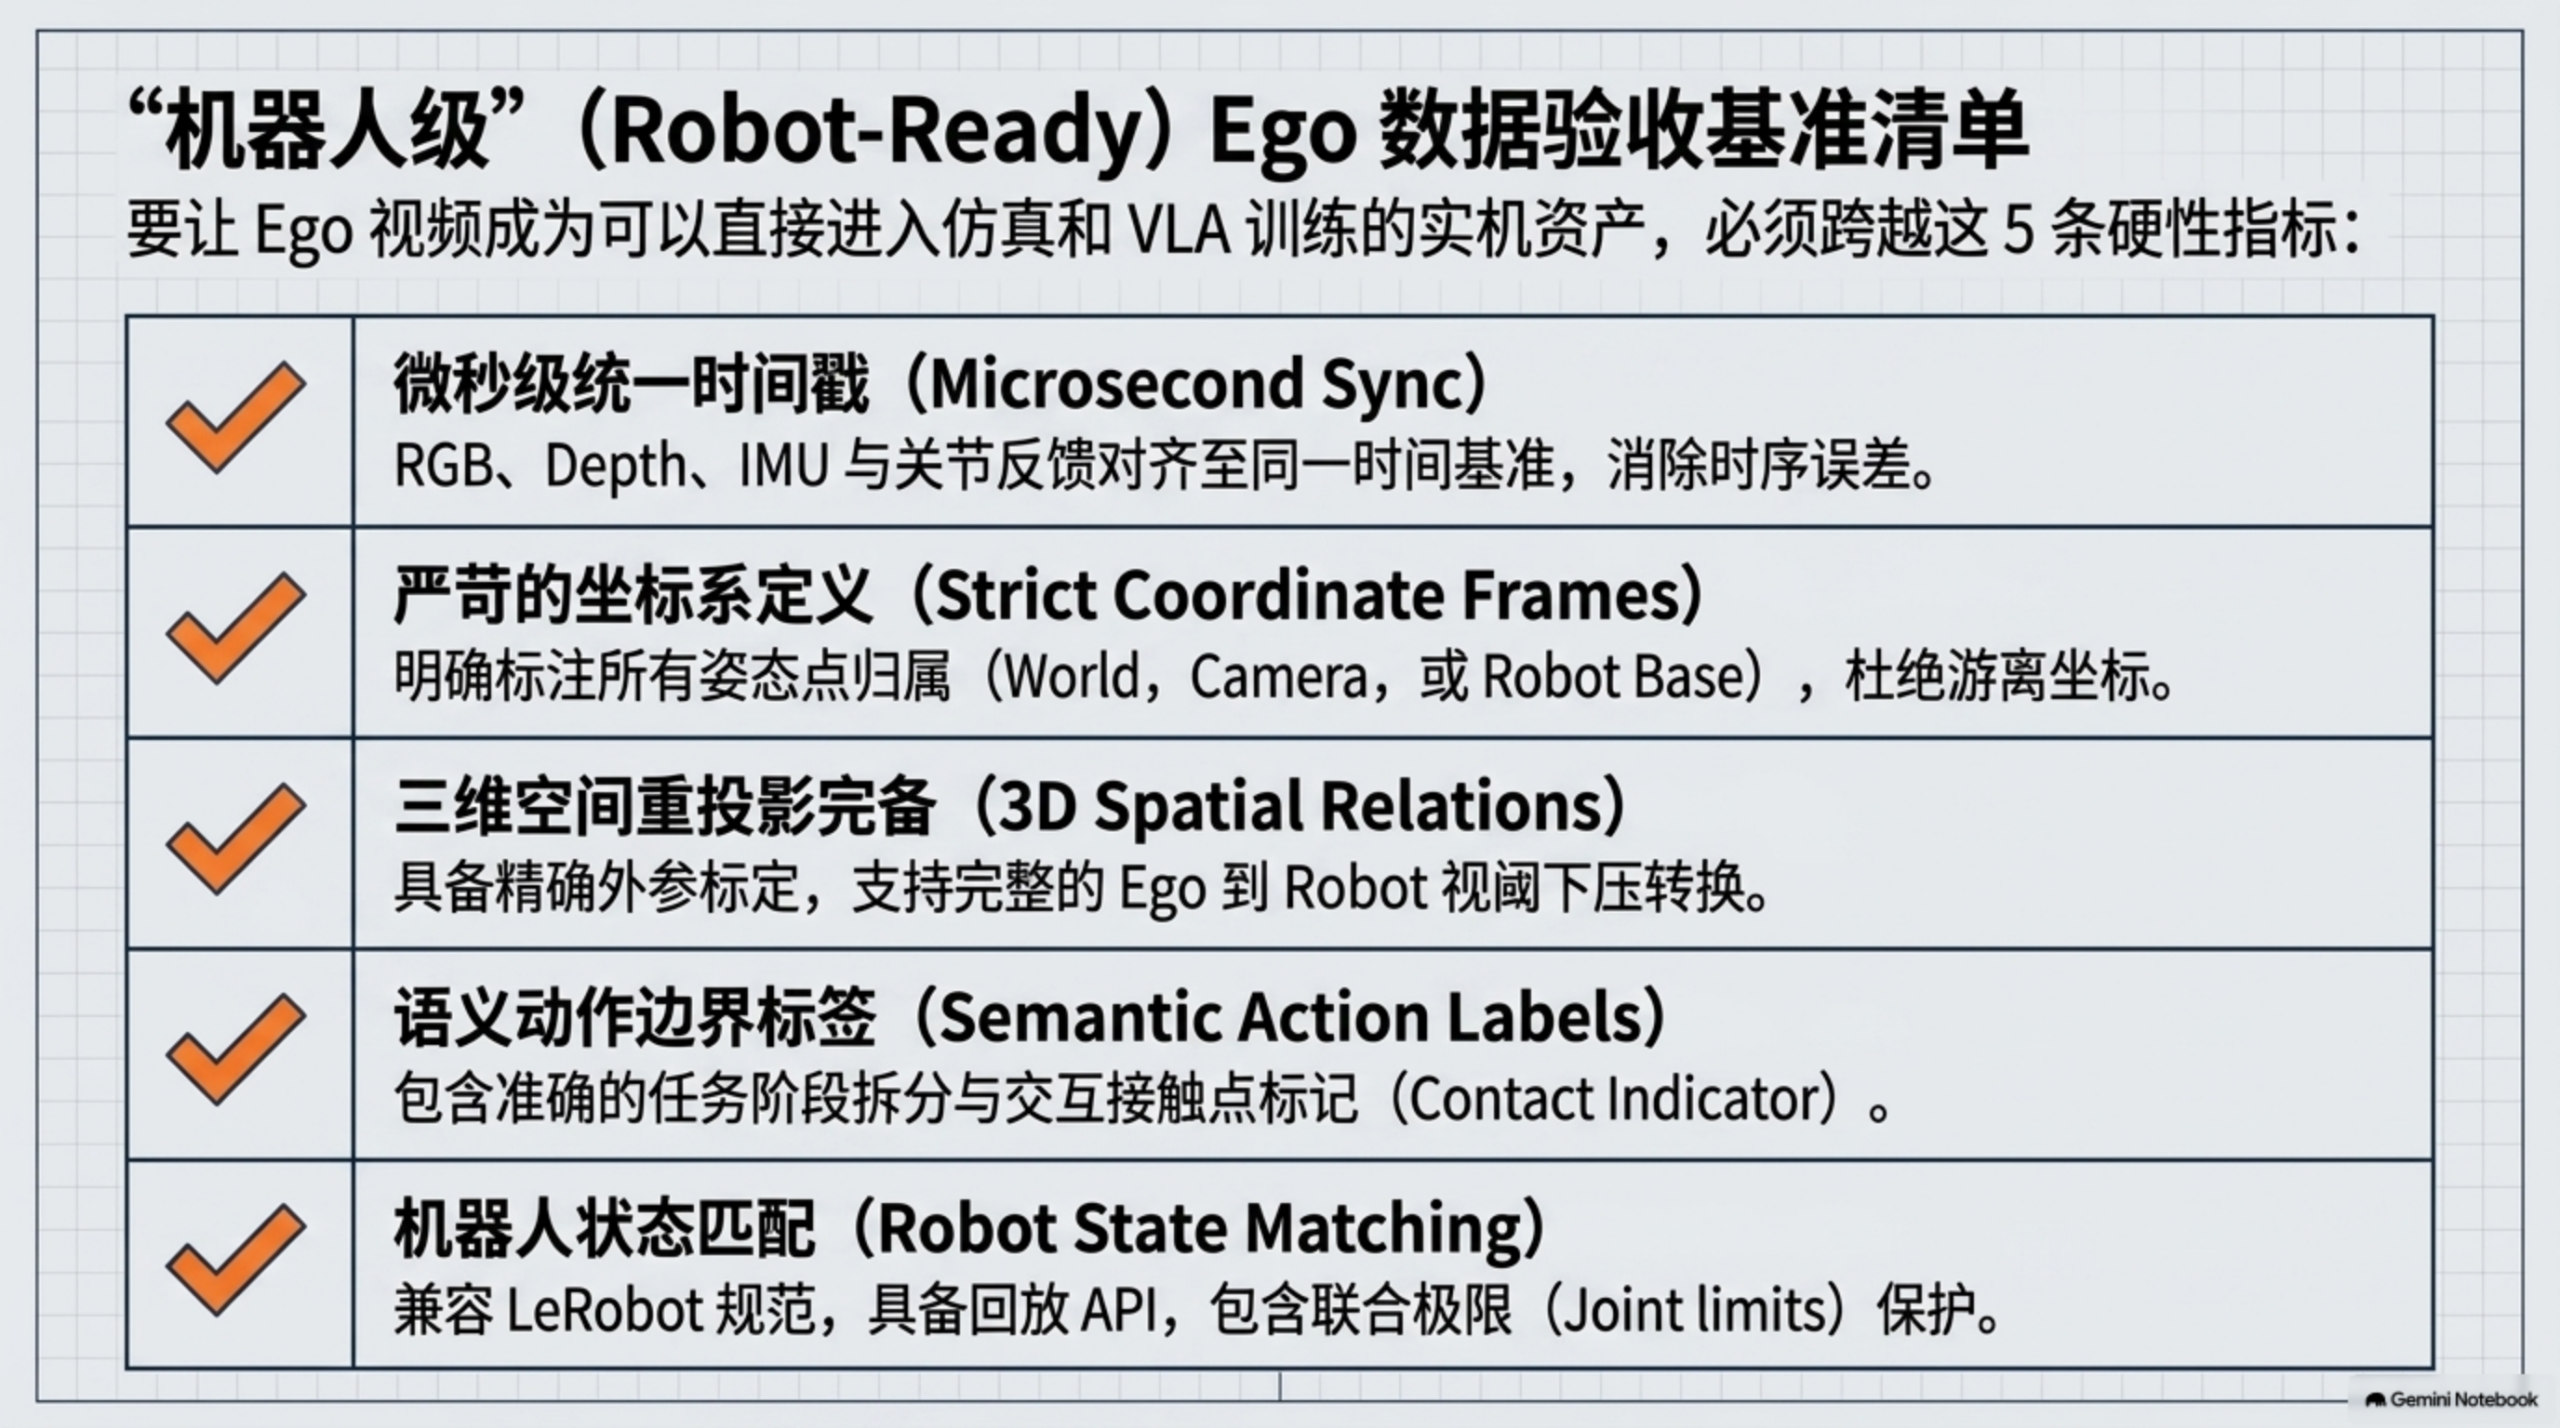
▲ 五条全过,才算机器人级数据
一,微秒级统一时间戳:RGB、深度、IMU 与关节反馈对齐到同一时间基准,消除时序误差。二,严苛的坐标系定义:所有关键点标明归属,杜绝游离坐标。三,三维空间重投影完备:精确外参标定,支持 Ego 到 Robot 的视角下压转换。四,语义化动作边界标签:任务阶段拆分加交互触点标记。五,机器人状态匹配:兼容 LeRobot 规范,具备回放 API,带关节极限保护。
EgoVerse 的采集协议是这份清单的现实版:双手全程可见、动作果断不犹豫、人工质检逐条把关、每段数据附采集人、场景、物体全套元数据。做到了这些,Ego 视频才配叫数据资产。
EgoVerse 有三个结论值得记下:人机数据共训明确涨点,这是首次在跨实验室、跨本体的标准化协议下得到验证;scaling 的前提是对齐数据做锚;数据预算紧张时,场景多样性比人数多样性更值钱——换 16 个场景比换 16 个人更能涨泛化。
回到资产观。无本体数据的价值在于采一次、喂所有机器人:Aria 眼镜采的叠衣服数据,同一份可以喂双臂夹爪平台,也可以喂 G1 灵巧手平台。Ego 数据正在把机器人的训练场,从受限的实验室解放到广阔的人类真实世界。
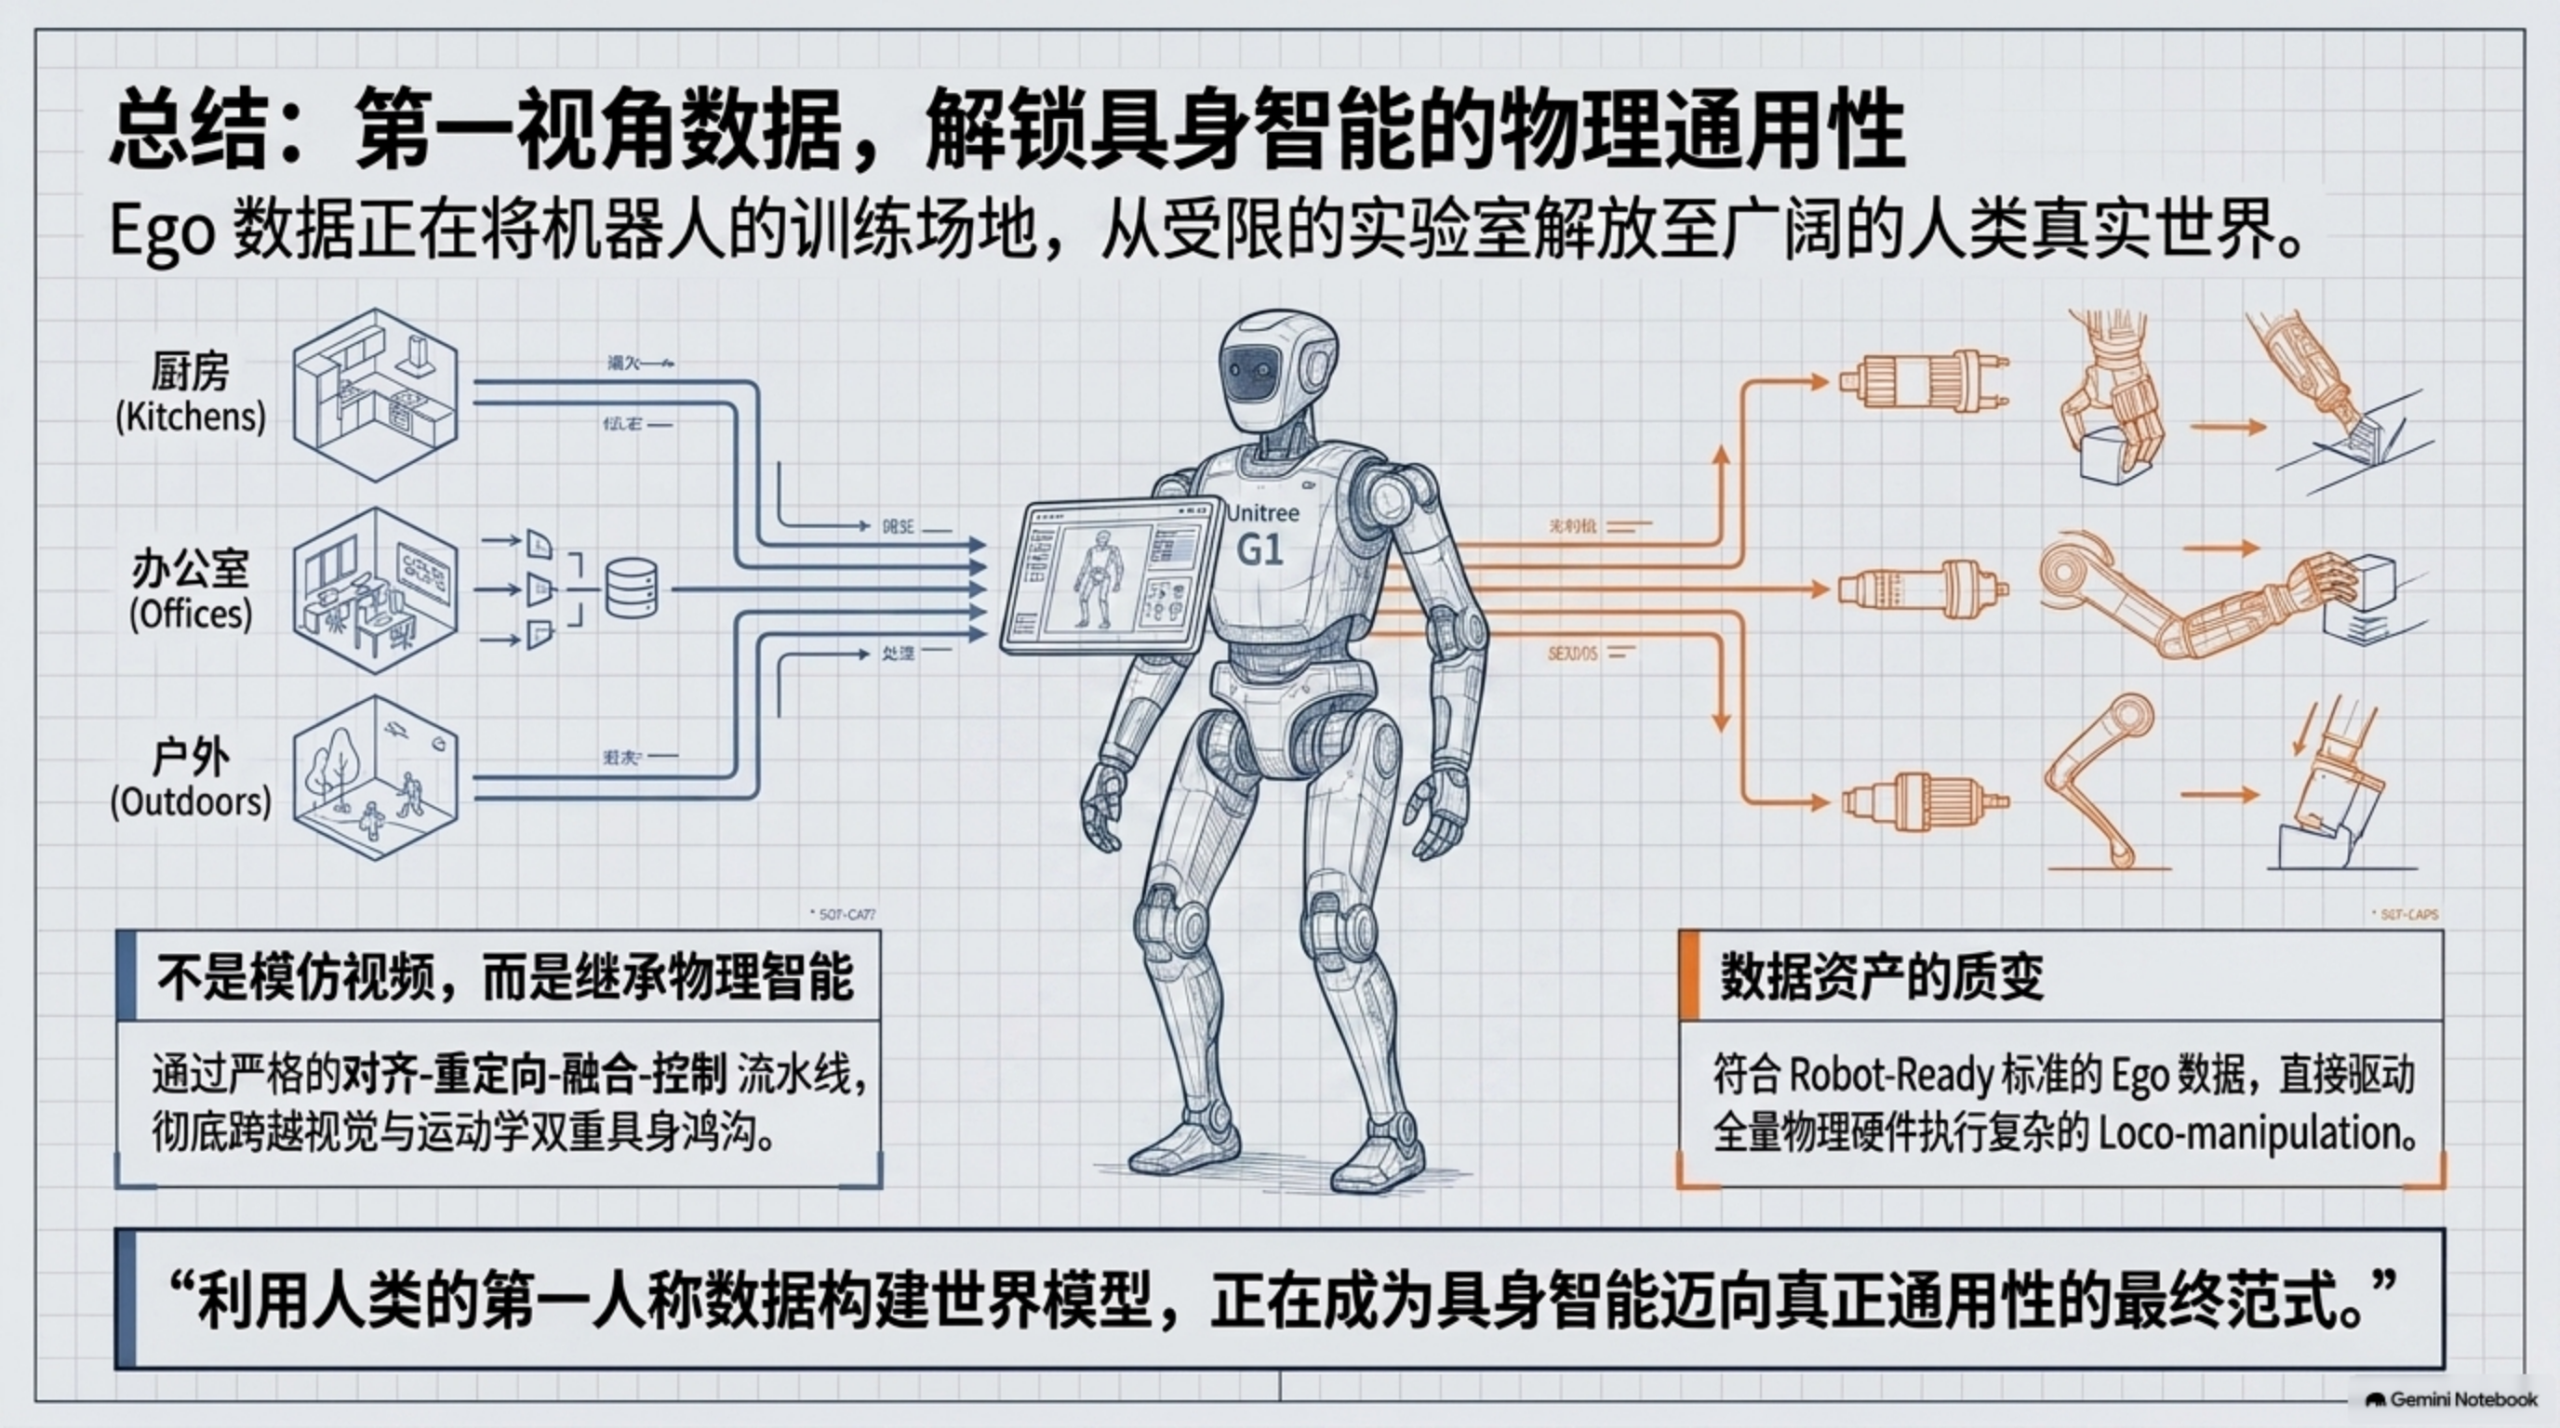
▲ 厨房、办公室、户外,人干活的地方就是数据产地
不是模仿视频,而是继承物理智能。通过严格的拆解、重塑、融合、控制流水线,彻底跨越视觉与运动学双重具身鸿沟——利用人类的第一人称数据构建世界模型,正在成为具身智能迈向真正通用性的最终范式。
来源:https://mp.weixin.qq.com/s/yrmtvkWtP1939a6YwKuVaQ
2025年,人形机器人产业迎来爆发拐点。特斯拉Optimus量产在即,华为、宇树等企业加速技术突破,行业正从“实验室研发”向“规模化落地”跃迁为打通产业链上下游协作壁垒,艾邦机器人正式组建"人形机器人全产业链交流群",覆盖金属材料、复合材料、传感器、电机、减速器等全硬件环节,助力企业精准对接资源、共享前沿技术!
扫码关注公众号,底部菜单申请进群