

数据采集热不热,不重要;采出来的数据能不能用,才重要。
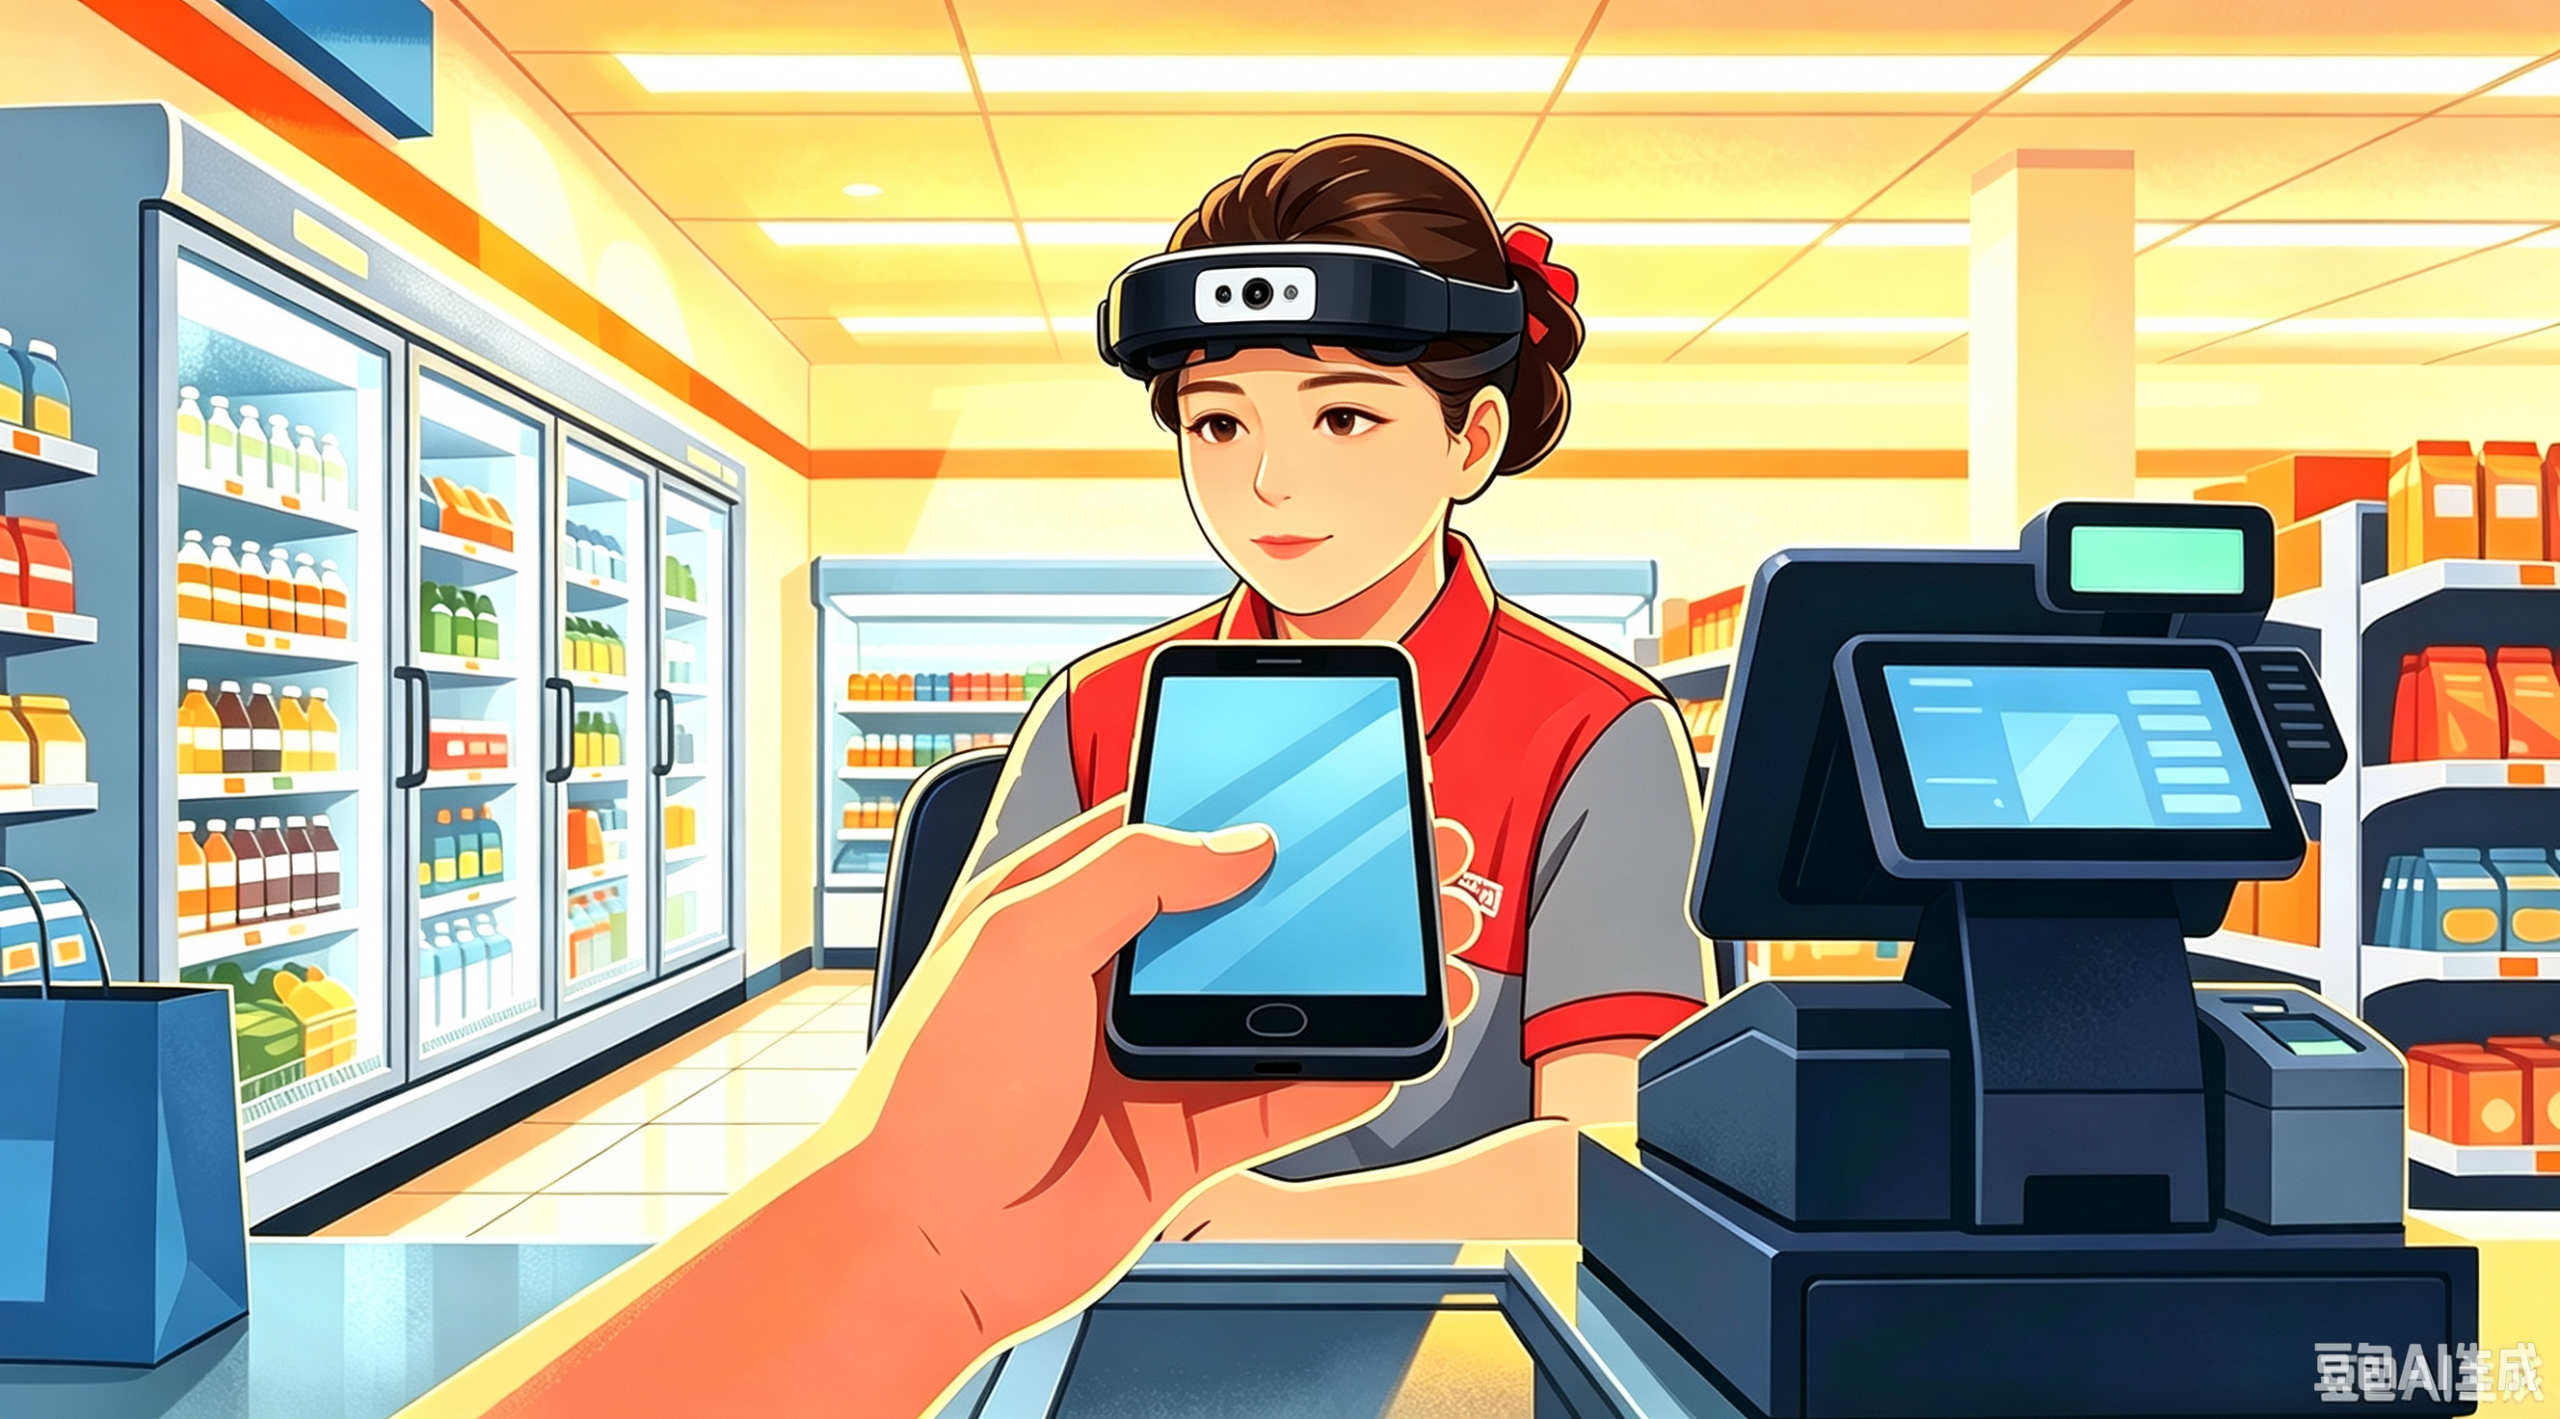
“客户要求真实场景,但又不能拍到别人的手、脸或者其他部位,只能有第一人称的动作,但结账、流水线这种很难避免。”
既要真实场景,又不能拍到真实世界里一定会出现的人。这不是段子,而是来自Ego数据采集厂最真实的吐槽。
但这还真不能怪数据公司要求刁钻,而是 Ego数据路线天然决定了第一人称视频素材必须得干净。
“真实”和“干净”撞在一起,成了2026年具身智能数据采集赛道里一个矛盾的痛点。
01 数据饥渴,把采集员变成了“AI老师”
2026年,人形机器人集体进入“量产元年”的舆论场,但机器人真正缺的,不是胳膊腿,是“脑子”——准确说,是训练大脑的数据。
机器人学干活,跟人不一样。人看一遍就会,机器人要看成千上万遍。拿一杯水、叠一件衣服、扫一次地,都要有海量“演示数据”喂进去,它才学得会。
佐思汽研和水清木华研究中心联合发布的《2026年具身智能机器人数据产业布局研究报告》显示,2025年全球具身智能数据市场规模达2.42亿美元,同比增长181.4%,其中中国市场约5亿元人民币,同比增长203%;报告预计到2030年,全球市场总规模将攀升至52.5亿美元。
热钱闻着味就来了:光轮智能估值半年破150亿元,成了全球首个具身数据独角兽;京东在宿迁建起全国首个具身智能数据采集社区,计划发动10万+员工和50万行业人员;招聘平台上,“具身智能数据采集员”的岗位密密麻麻,标签清一色是“日结薪资、居家可做、无学历要求”。
于是,一批批普通人戴上设备,成了机器人的“AI老师”。
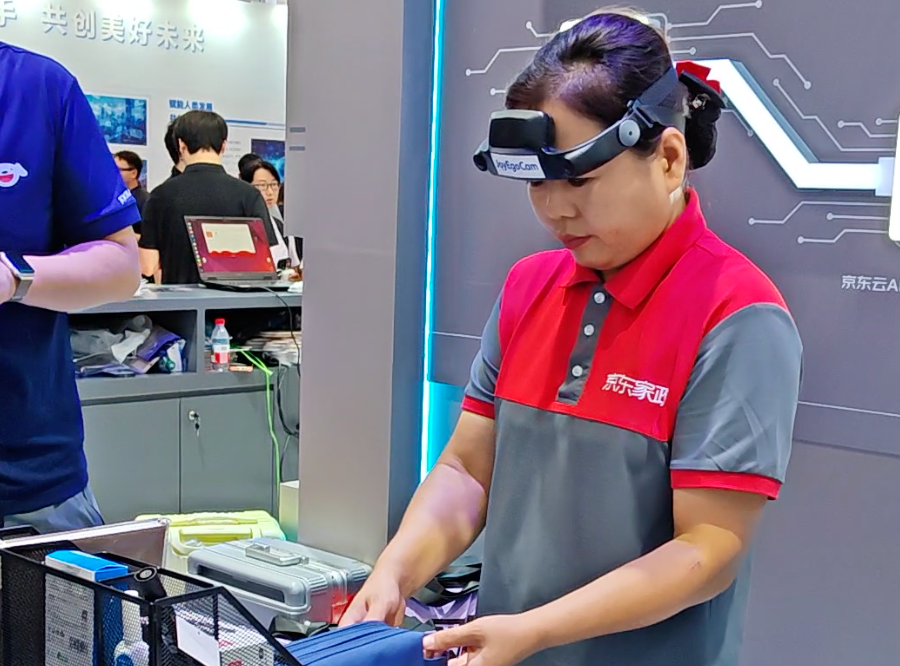
图1:Ego 采集员,京东
02 Ego是个啥?简单说,就是“用第一人称拍自己干活”
Ego,是 Egocentric(第一人称视角)的缩写。在具身智能圈,它特指一种数据采集方式:让人戴着头戴式设备,以自己“眼睛”看到的视角,把干活过程录下来,同步记录视觉、头部运动、手部动作和交互信号,形成一套“感知—行动”对齐的数据流。
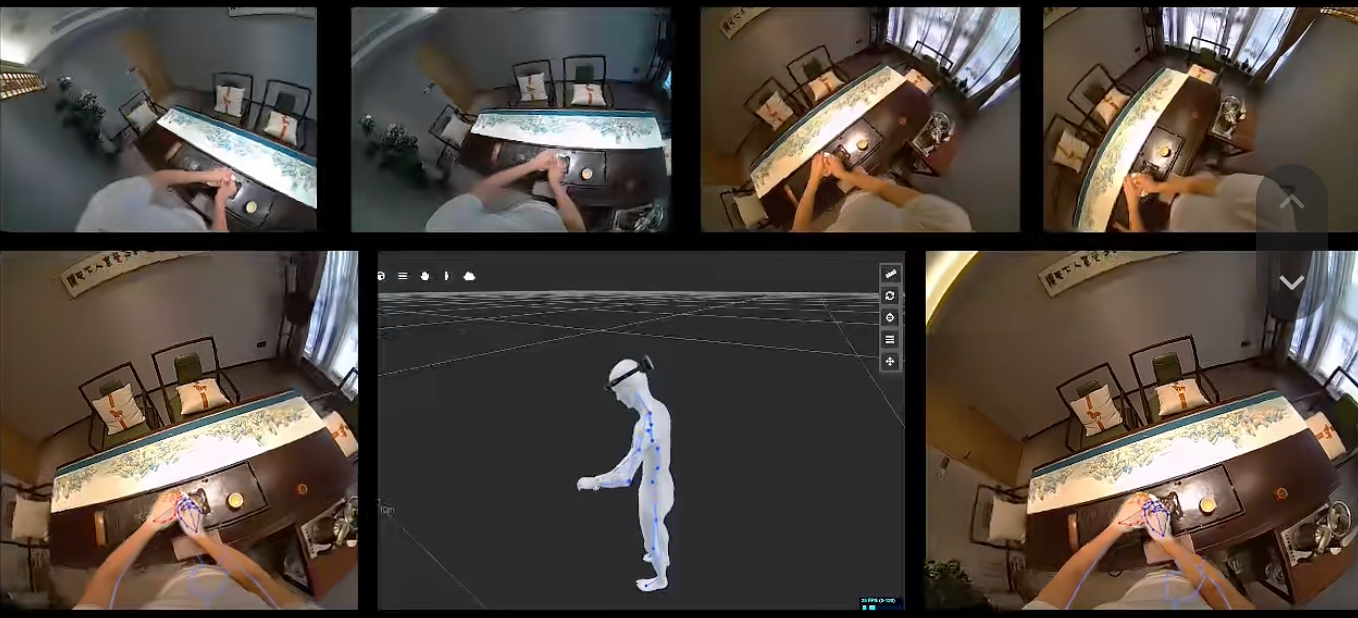
Ego 采集第一视角,简智机器人
这套设备不复杂:头戴式RGB/深度相机当“眼睛”,IMU惯性传感器记“平衡感”,腕带/手套传感器捕捉手部关键点,讲究的还要加眼动追踪、肌电传感器。单台设备每小时能产出50GB到200GB原始数据——数据量大到存储本身就是个工程问题。
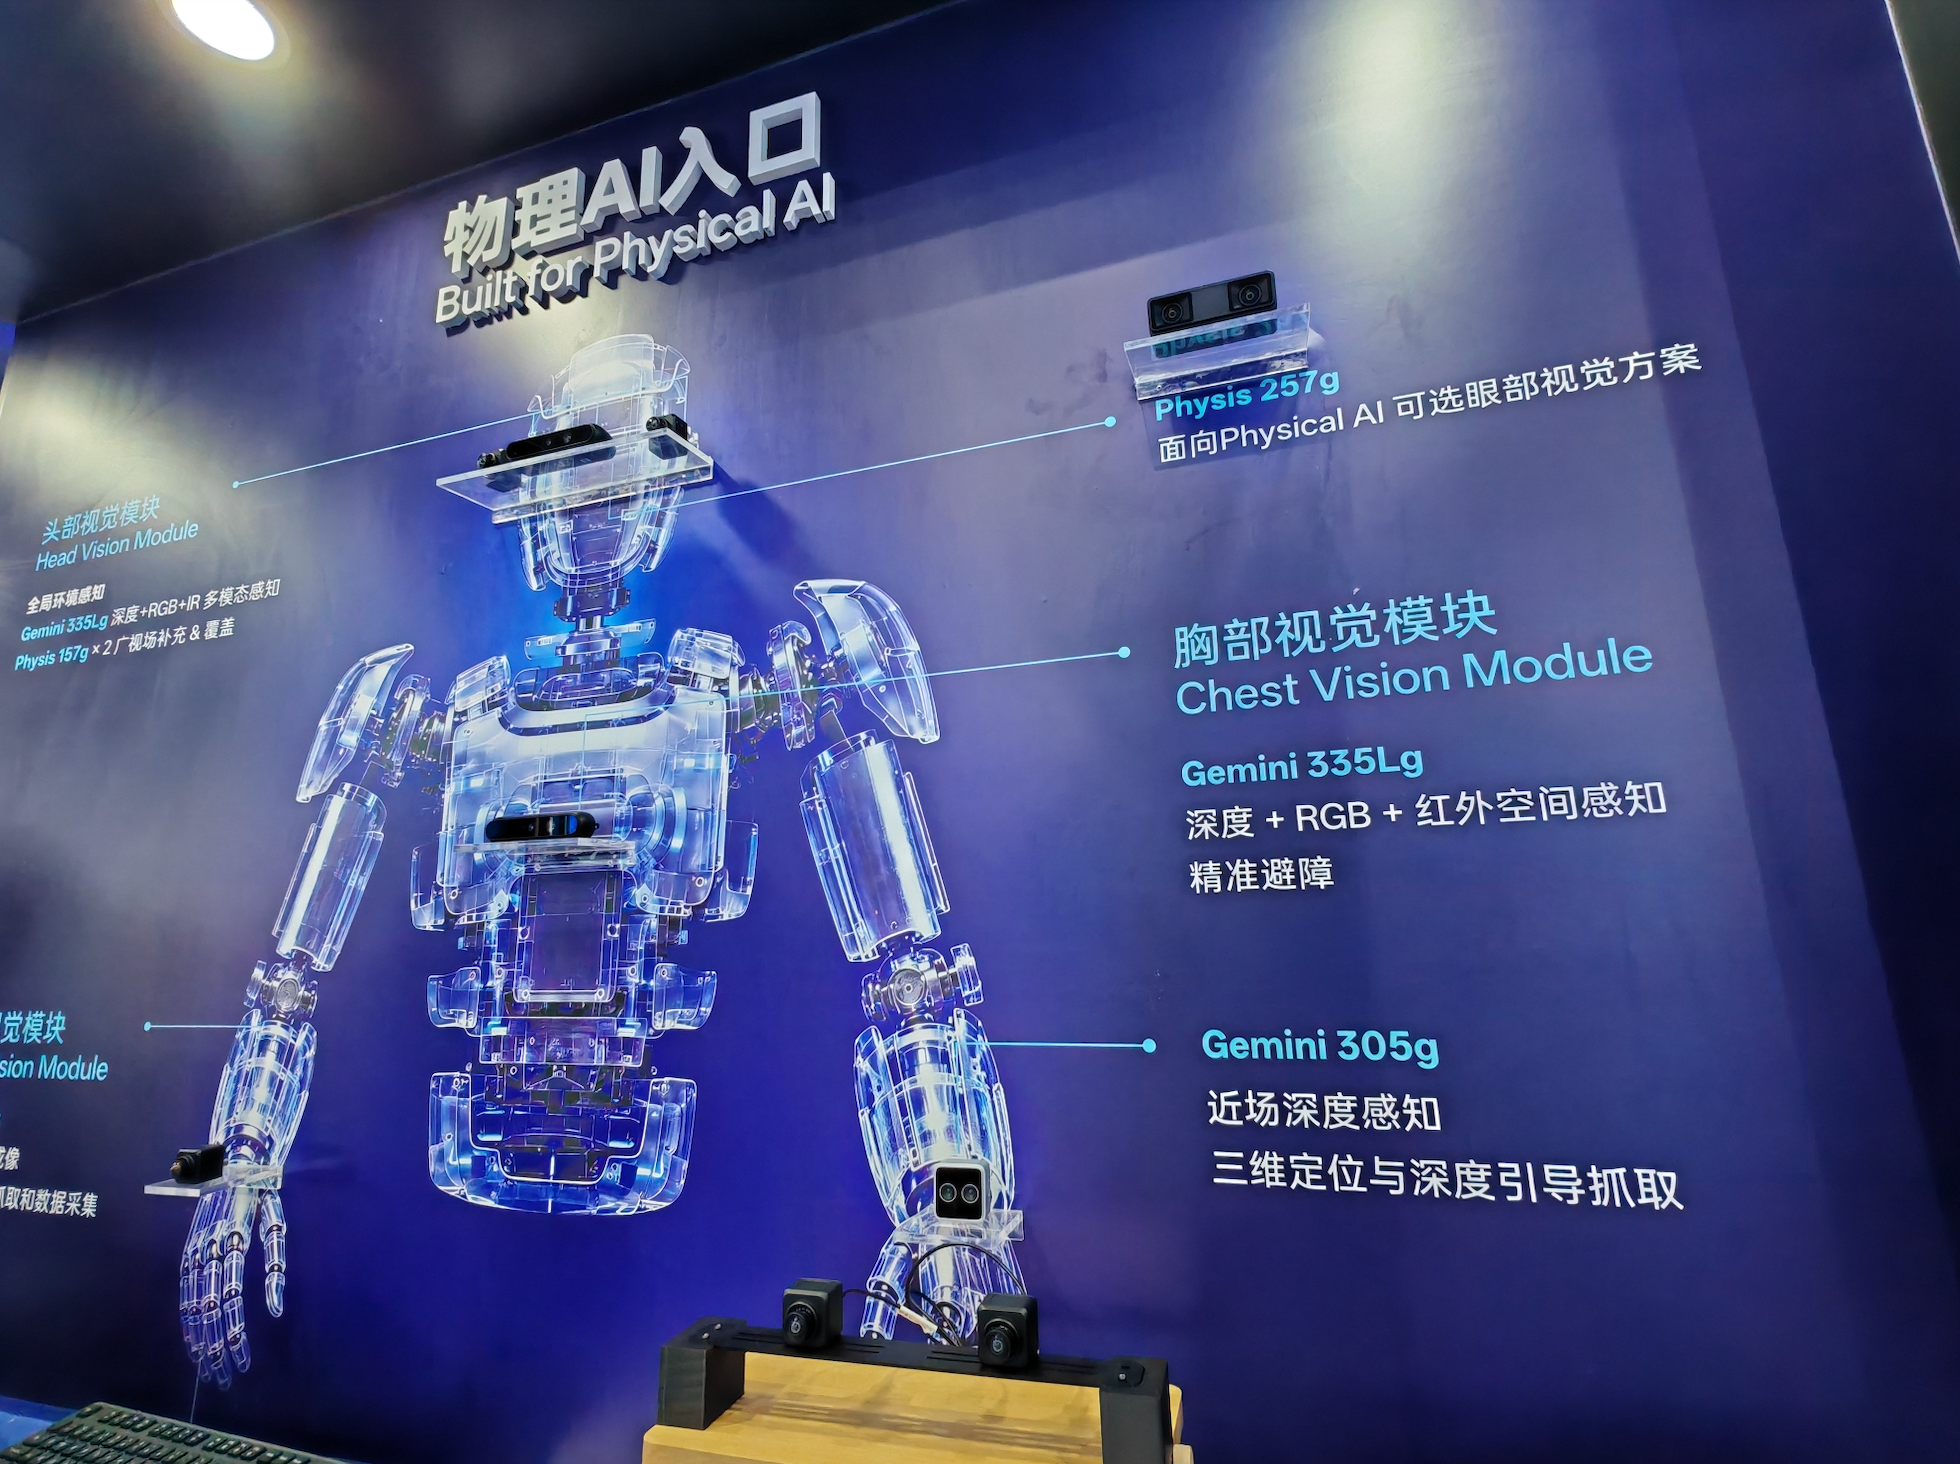
Ego 数据采集设备,奥比中光
为什么要费劲用第一人称?
因为机器人最终是从自己头部的摄像头看世界的,如果训练数据全是第三人称拍的“监控视角”,模型部署到机器人上,性能普遍下降20%到40%。反过来,第一人称数据的视角和机器人头部相机天然同构——机器人看到什么,和“老师”当时看到什么,一模一样。
那这些第一人称视频,是怎么变成机器人能学的动作的?
中间隔着三步:先提取、再重建、后投映。
第一步,数据公司用视觉算法从视频里逐帧提取关键点——手部关节、身体骨架;第二步,把关键点重建成立体的三维模型,还原人的动作轨迹;第三步,把三维动作“投映”(业内叫运动重定向)到机器人身上,让机器人照着人类的动作范式去执行。
关键就在第一步。算法提取关键点,靠的是画面里“只有一个人”。一旦镜头里混进第三方的手、脸、胳膊,算法分不清关键点属于谁,提取就乱了,三维模型重建出来也是错的,再投映到机器人身上,动作自然学歪。所以客户才反复强调“画面要干净”——这不是甲方洁癖,是技术链条的硬要求。
Ego 数据路线之所以受欢迎,是因为相比其他数据路线,它足够便宜。业内公开信息显示,真机遥操作(人远程操控机器人本体干活)单小时有效数据成本约500到1000元,最高能到1600元;而Ego采集,成本大约是前者的1/200。门槛低、可众包、居家就能干,Ego因此成了入局者最多的路线——也是卷得最快的路线。
03 数据好“采”,但“能用”是另一回事
然而,行业有多热,数据就有多“虚”。有媒体报道称,无本体众包数据的实际可用率普遍不足三成:动作不规范、场景摆拍、手部离开画面、设备抖动……采集时拍了100条,清洗完能用的可能不到30条。
数据采集员一天工作8小时,有效采集时长常常只有2到5小时,剩下时间在调试设备、重录、等场景。更扎心的是,“有效数据”的定义掌握在客户手里——客户说不行,就是不行。
数据“脏”还会传染模型。一位数据公司负责人举过一个经典案例:采集员习惯拿起茶杯先吹气降温,模型便以为“吹气”是拿杯子的必要前置动作,结果训练出的机器人每次抓握茶杯,都会对着空杯停顿一下——它以为自己漏了一步。
圈内流传一句大实话:“数据越多不一定越好,但数据越脏一定越糟。”数据不足可以补采,数据污染要先清洗再返工,相当于走回头路。
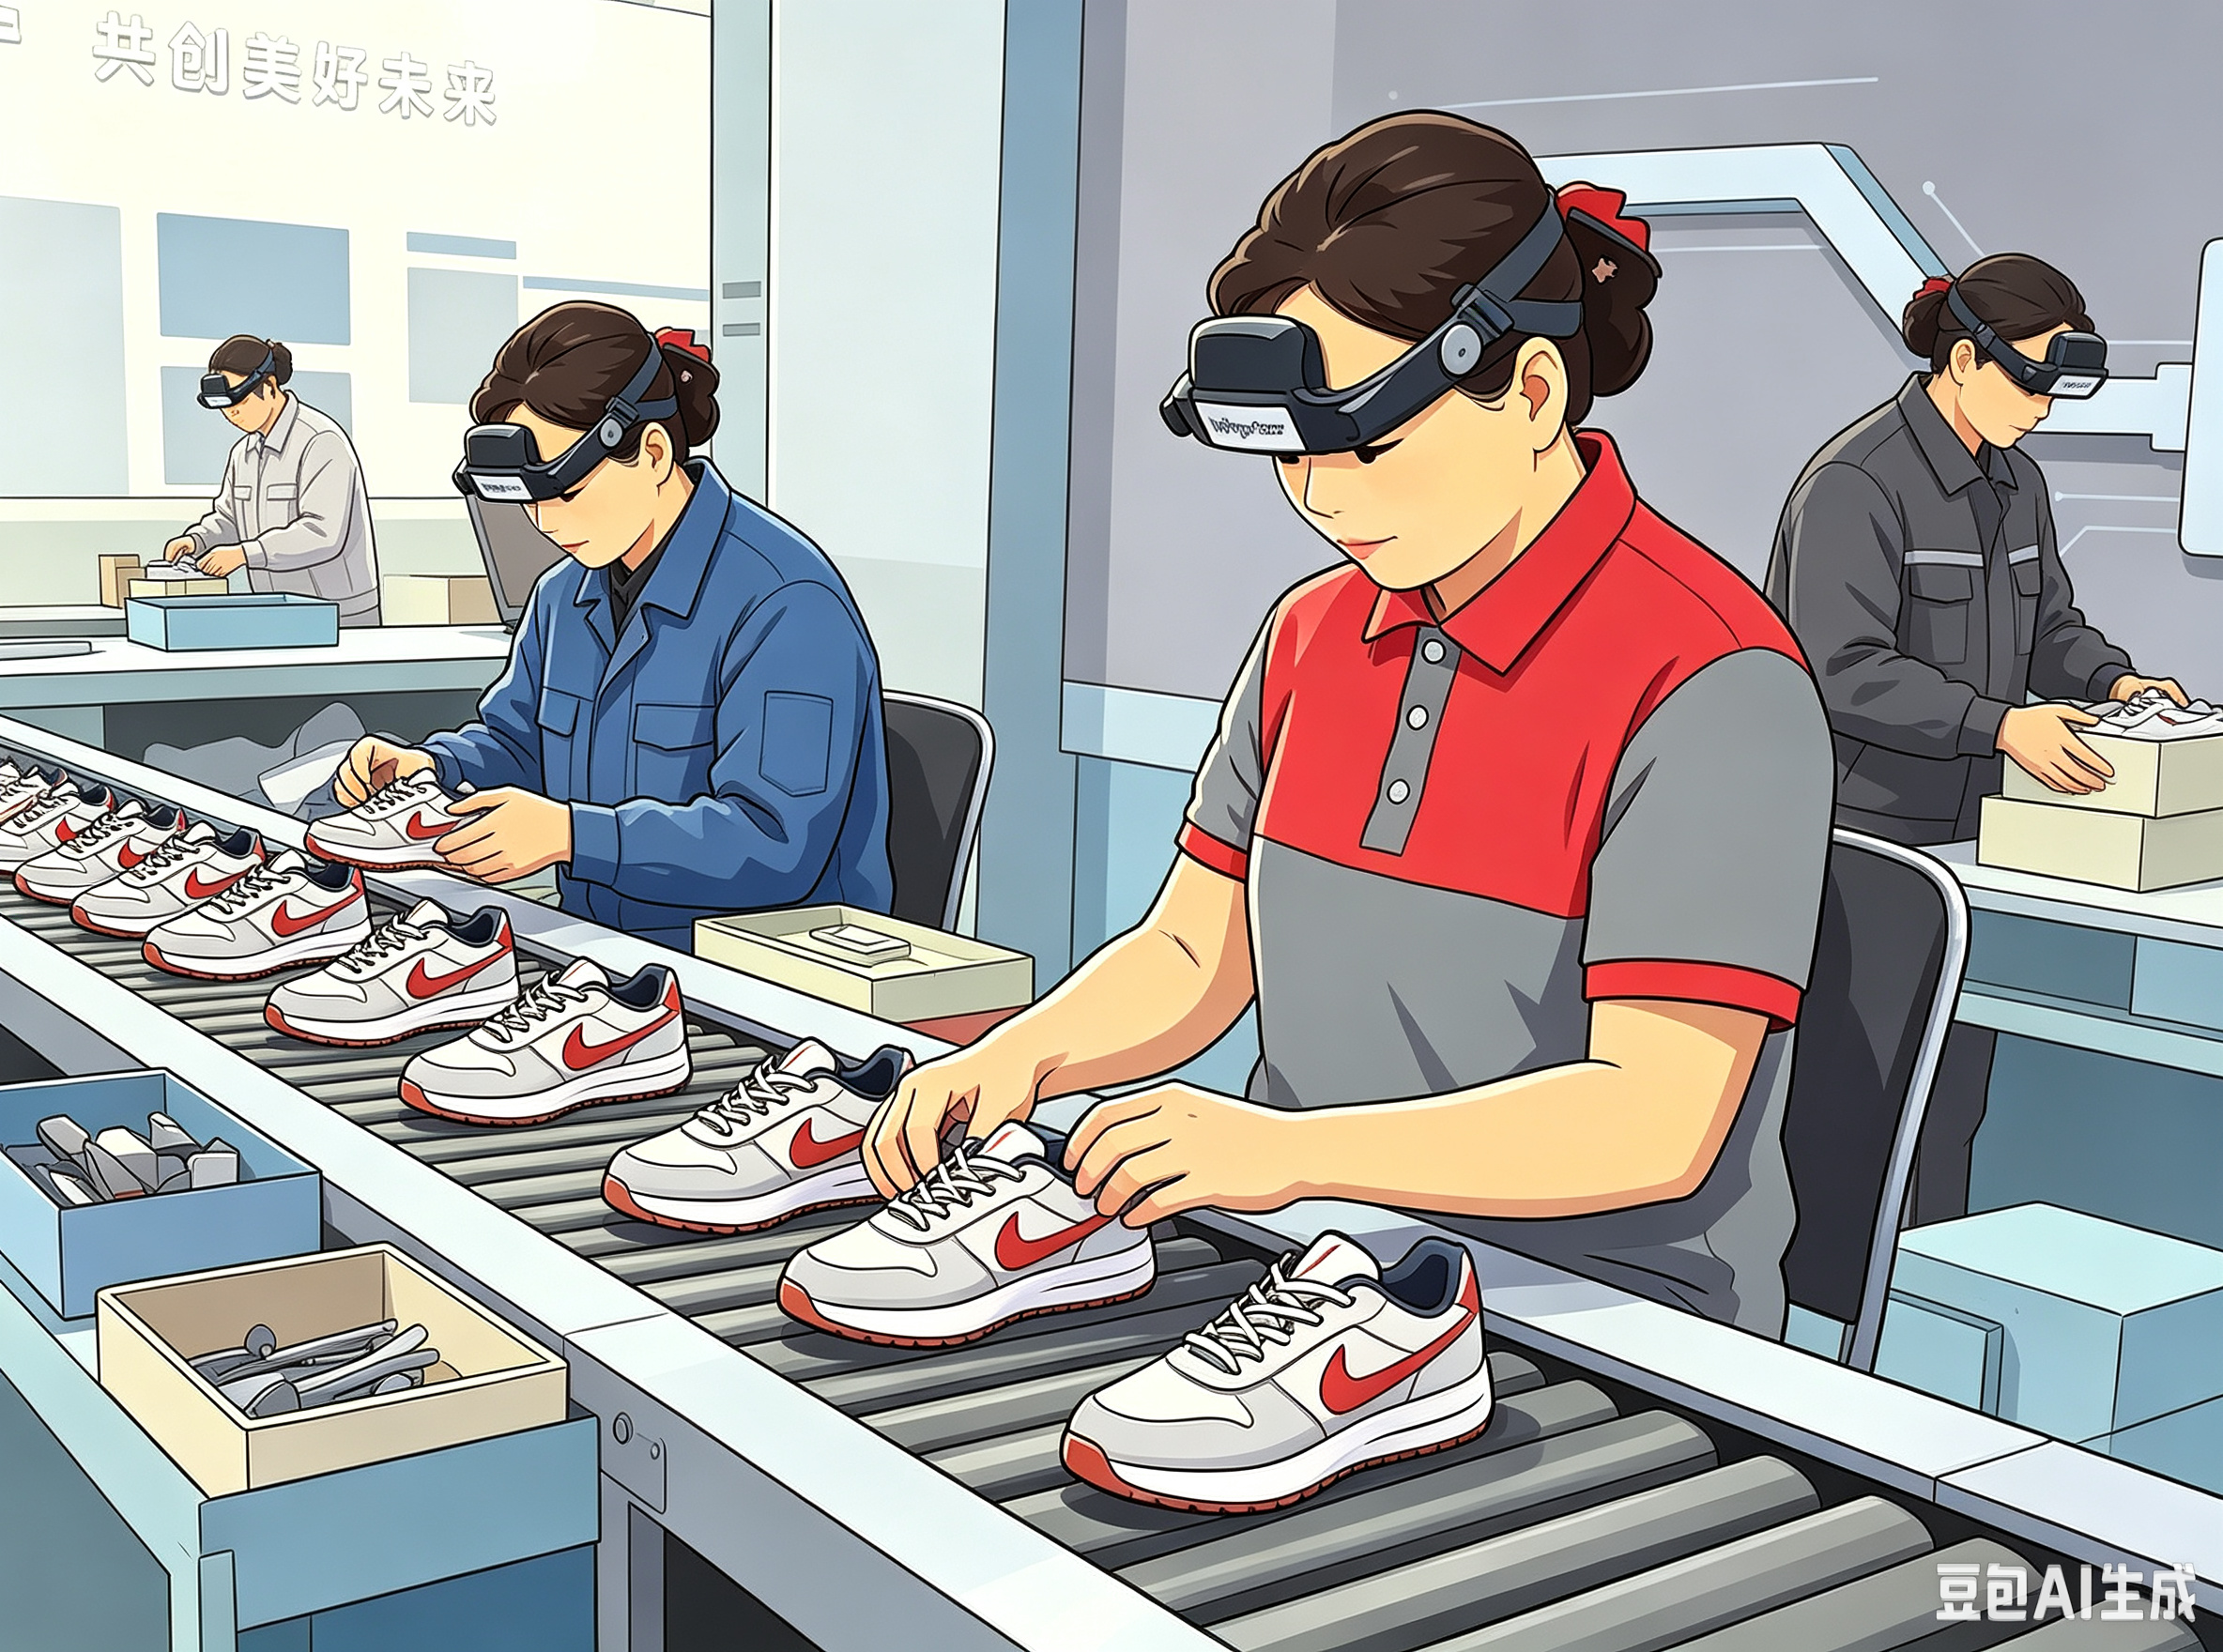
图2:生产线上的工位一个挨一个,想不拍到邻座同事很难(AI生成示意图)
04 回到那个矛盾:真场景,和不拍到别人,能两全吗?
客户要“真实场景”,本质是要数据有生态效度——机器人将来要进便利店、上产线,训练数据就得来自真实环境,棚里摆拍出来的数据,一落地就露馅。有媒体就报道过,很多团队在实验室跑通的算法,搬到真实产线或家庭场景就跑不通,根因不是算法不行,而是训练数据与真实场景的分布偏差太大。
可“真实场景”里,天然挤满了人。便利店结账,顾客的手就是画面的主角;生产线操作,工人们坐得近,就难免会拍到他人的胳膊、手甚至脑袋。画面里多出一只手,后面“提取关键点—重建三维模型—投映到机器人”的整条链路都会跟着出错,这一帧数据基本就废了。
于是两难闭环了:不拍真实场景,数据没用;拍了真实场景,就容易拍到别人;避开别人,数据又失真。
更别提成本账。做这行的人越来越多,客单价被卷得越来越低;而想进真实工厂合作,难度比想象中高得多——工厂怕泄露工艺、怕影响生产,谈一家真实产线合作,周期比采集本身还长。采集厂夹在中间,像极了那句玩笑:客户要“五彩斑斓的黑”。
05 热闹是真的,路长也是真的
把话说回来:Ego数据采集这行,确实站上了风口。10亿级预算、百万小时数据计划,行业喊得震天响;全球能用高质量交互数据据行业估算只有约50万小时,而让机器人“开箱即用”据说需要一亿小时量级——缺口就是机会,机会就是热度。
但热度不等于成熟。从“采下来”到“用得上”,中间隔着清洗、标注、质检、合规一道道工序;从“别人家的真实场景”到“自家能进得去的场景”,隔着谈判桌上一道道坎。数据采集看似热闹,实则粗活、脏活、慢活,赚的是辛苦钱,扛的是高不确定性。
那些涌进来的入局者,大概率会先经历一轮淘汰:低价接单的、粗制滥造的、拿“垃圾数据”反复流通的,都会被真实需求筛掉。留下来的,要么有稳定场景资源,要么有把数据做“干净”的真本事。
数据采集热不热,不重要;采出来的数据能不能用,才重要。这行要走的道路,比热搜上的“元年”长得多。
END
2025年,人形机器人产业迎来爆发拐点。特斯拉Optimus量产在即,华为、宇树等企业加速技术突破,行业正从“实验室研发”向“规模化落地”跃迁为打通产业链上下游协作壁垒,艾邦机器人正式组建"人形机器人全产业链交流群",覆盖金属材料、复合材料、传感器、电机、减速器等全硬件环节,助力企业精准对接资源、共享前沿技术!
扫码关注公众号,底部菜单申请进群